
LeRobot documentation
LIBERO
LIBERO
The commands below run the simulator locally. To keep its dependencies away from your policy's, serve it instead with `lerobot-env-server --config_path=docker/sim/configs/libero.yaml --sim.task=--docker=true`, where ` ` is the command's `--env.task`, and add `--env.server.endpoint=tcp/127.0.0.1:7448` to the command. A server runs the task it was started with (see [Simulation: local or served](./simulation)).
LIBERO — это бенчмарк, разработанный для изучения постоянного обучения роботов — концепции, согласно которой роботы должны продолжать учиться и адаптироваться к своим пользователям со временем, а не просто проходить однократную предварительную подготовку. Он предоставляет набор стандартизированных задач манипулирования, сфокусированных на переносе знаний: насколько хорошо робот может применять уже полученные знания в новых ситуациях. Проводя оценку на LIBERO, можно справедливо сравнивать различные алгоритмы, а исследователи могут опираться на работы друг друга.
- Статья: Benchmarking Knowledge Transfer for Lifelong Robot Learning
- GitHub: Lifelong-Robot-Learning/LIBERO
- Сайт проекта: libero-project.github.io
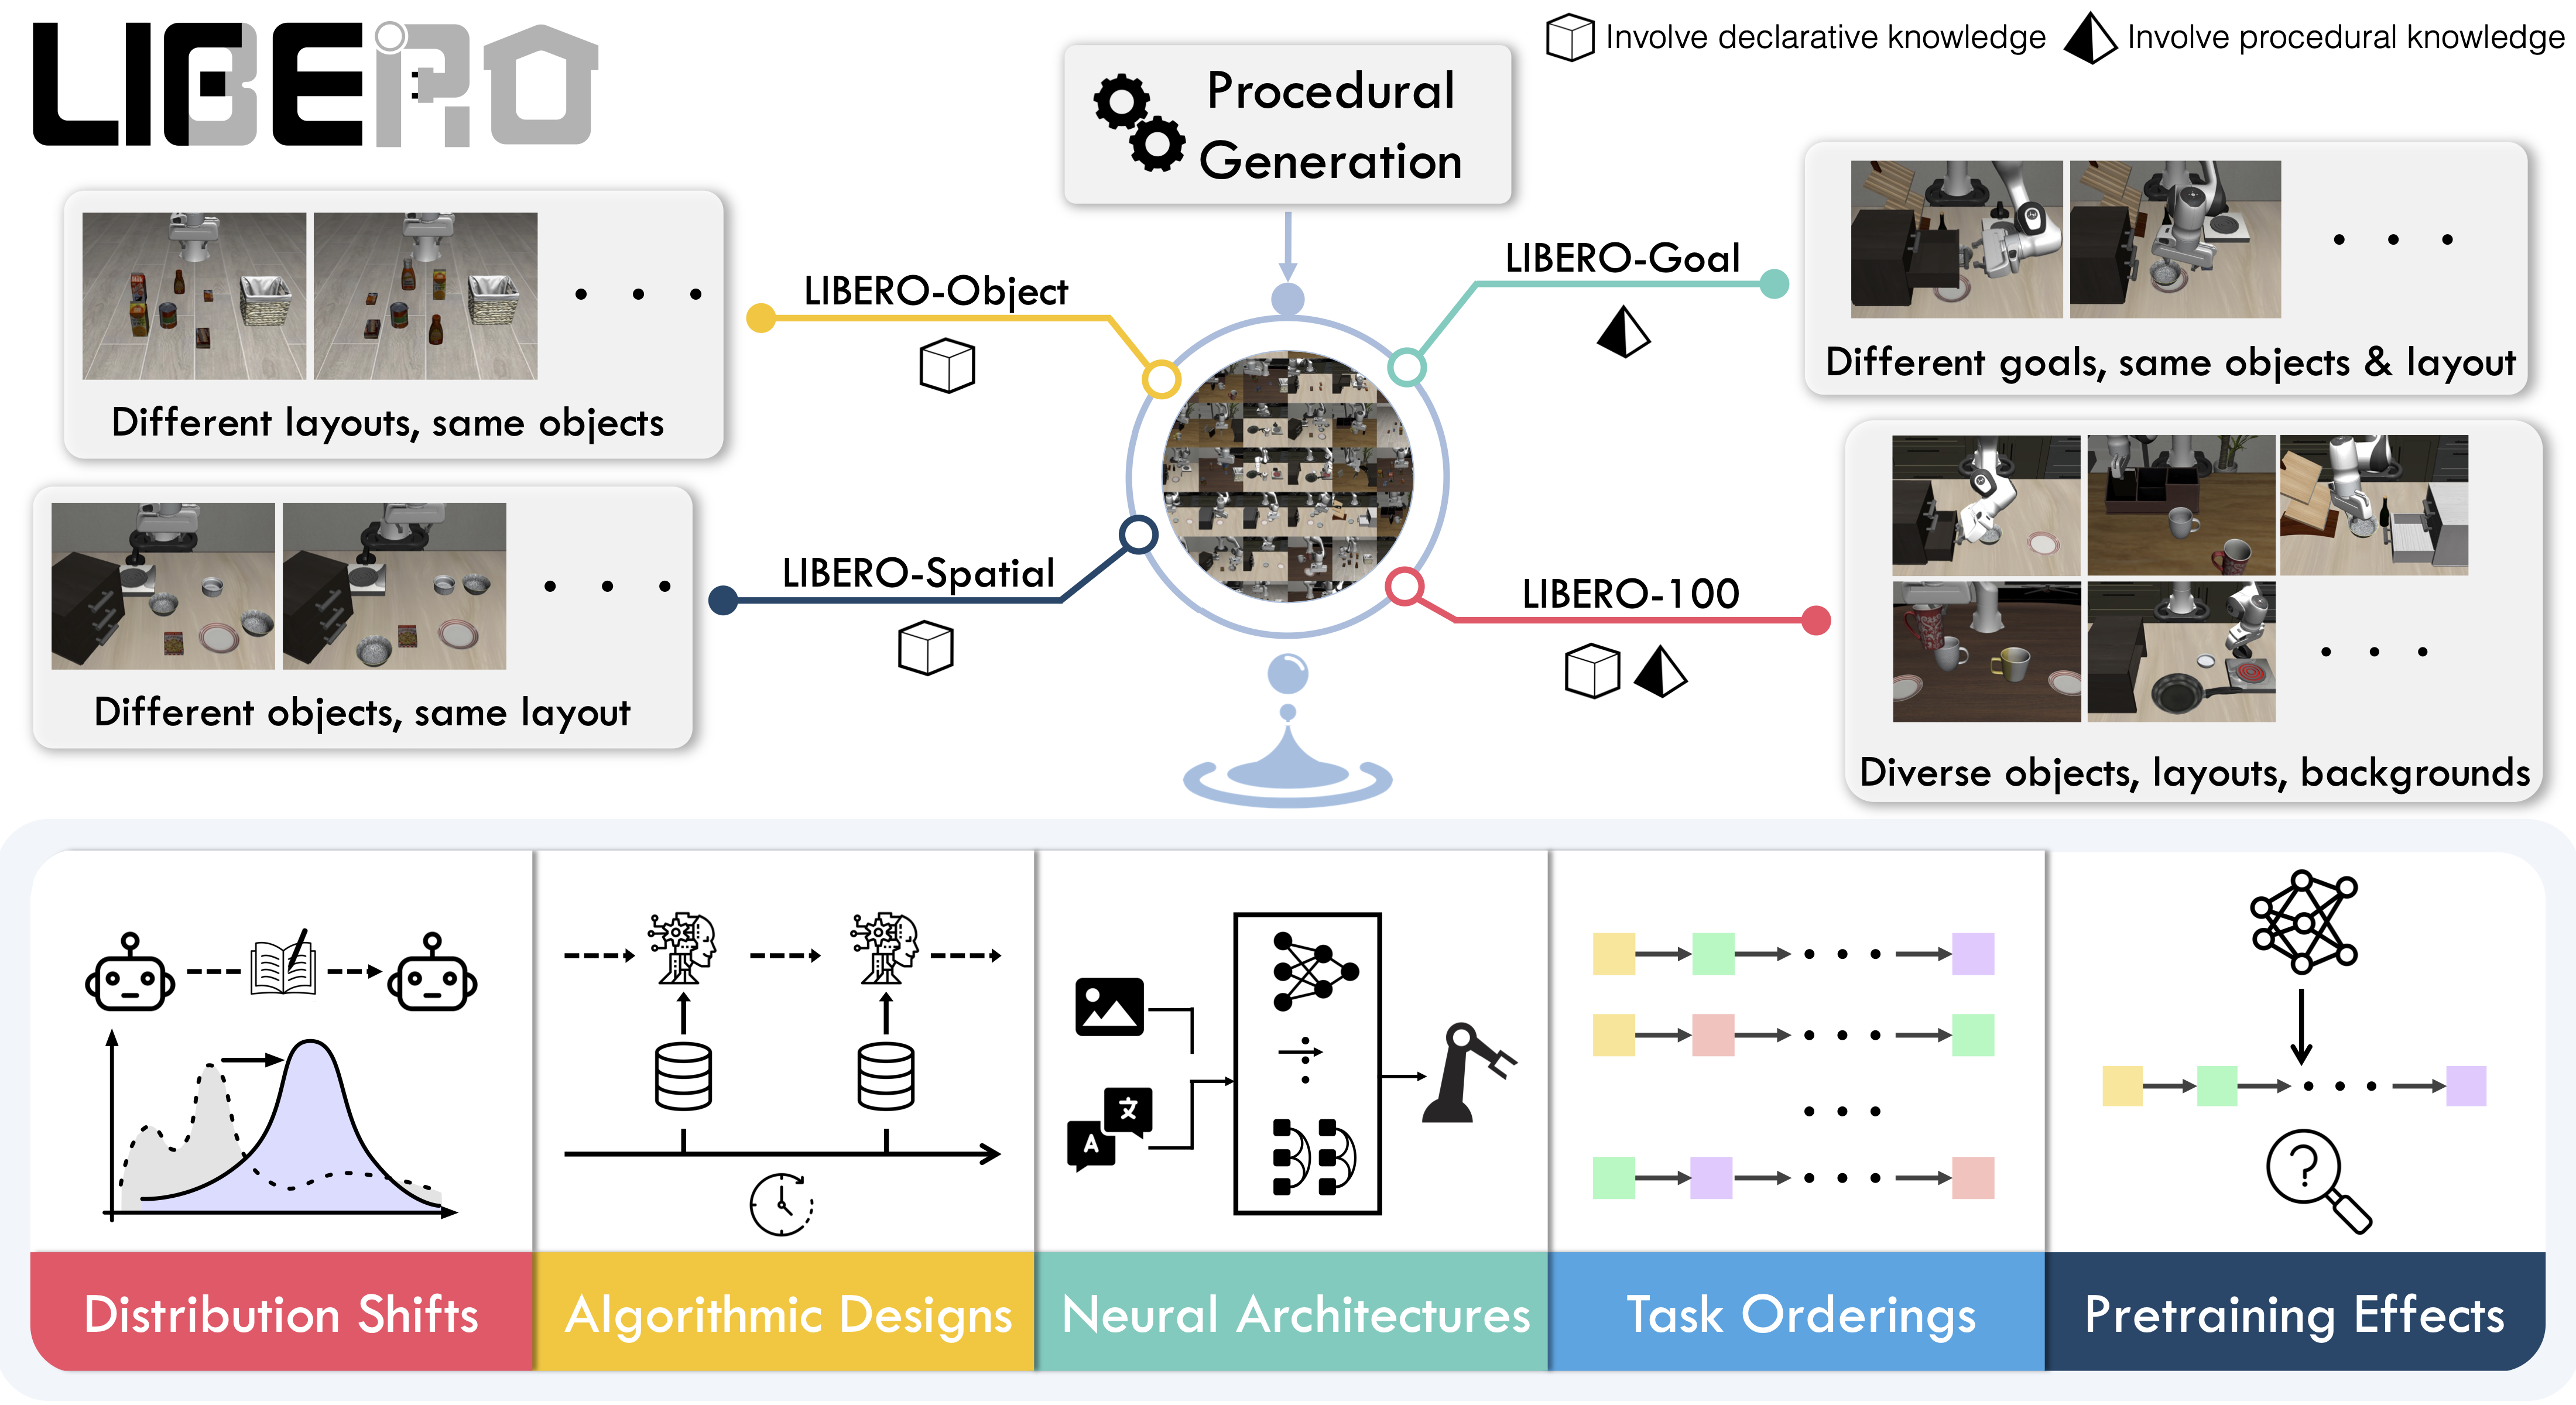
Доступные задачи
LIBERO включает пять наборов задач, охватывающих 130 задач, от простых манипуляций с объектами до сложных многошаговых сценариев:
| Suite | Имя CLI | Задачи | Описание |
|---|---|---|---|
| LIBERO-Spatial | libero_spatial | 10 | Задачи, требующие рассуждений о пространственных отношениях |
| LIBERO-Object | libero_object | 10 | Задачи, связанные с манипулированием различными объектами |
| LIBERO-Goal | libero_goal | 10 | Задачи с целевым условием и изменяющимися целями |
| LIBERO-90 | libero_90 | 90 | Краткосрочные задачи из коллекции LIBERO-100 |
| LIBERO-Long | libero_10 | 10 | Долгосрочные задачи из коллекции LIBERO-100 |
Установка
После выполнения инструкций по установке LeRobot:
pip install -e ".[libero]"LIBERO requires Linux (`sys_platform == 'linux'`). LeRobot uses MuJoCo for simulation — set the rendering backend before training or evaluation:export MUJOCO_GL=egl # for headless servers (HPC, cloud)
Оценка
Локальная оценка по умолчанию
Оцените на четырёх стандартных наборах (10 эпизодов на задачу):
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --env.max_parallel_tasks=1
Оценка на одном наборе
Оценка на одном наборе LIBERO:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object \
  --eval.batch_size=2 \
--eval.n_episodes=3--env.taskвыбирает набор (libero_object,libero_spatialи т. д.).--env.task_idsограничивает выполнение конкретными индексами задач ([0],[1,2,3]и т. д.). Если параметр не указан, будут выполнены все задачи в наборе.--eval.batch_sizeуправляет количеством сред, работающих параллельно.--eval.n_episodesзадаёт количество эпизодов, выполняемых для каждой задачи.
Оценка на нескольких наборах
Чтобы протестировать политику сразу в нескольких наборах, передайте список через запятую:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object,libero_spatial \
  --eval.batch_size=1 \
  --eval.n_episodes=2
Режим управления
LIBERO поддерживает два режима управления — relative (по умолчанию) и absolute. Разные контрольные точки VLA обучаются с различными параметризациями действий, поэтому убедитесь, что режим соответствует вашей политике:
--env.control_mode=relative # or "absolute"Сброс производительности
По умолчанию LeRobot сохраняет поведение жёсткого сброса (hard-reset) LIBERO. При включённых фиксированных начальных состояниях можно перейти на мягкий сброс (soft reset), чтобы избежать повторной сборки модели симулятора и рендерера для каждого эпизода:
--env.init_states=true --env.hard_reset=falseМягкие сбросы выполняются быстрее, но после шагов стабилизации среды они не совпадают с жёсткими сбросами на уровне битов, поэтому наблюдения камеры и результаты политики могут незначительно отличаться. Используйте жёсткие сбросы при воспроизведении результатов бенчмарков.
Входы и выходы политики
Наблюдения:
observation.state— 8-мерные проприоцептивные признаки (позиция eef, ориентация в формате ось-угол, qpos захвата)observation.images.image— вид с основной камеры (agentview_image), HWC uint8observation.images.image2— вид с камеры на запястье (robot0_eye_in_hand_image), HWC uint8
LeRobot enforces the `.images.*` prefix for visual features. Ensure your policy config `input_features` use the same naming keys, and that your dataset metadata keys follow this convention. If your data contains different keys, you must rename the observations to match what the policy expects, since naming keys are encoded inside the normalization statistics layer.
Действия:
- Непрерывное управление в
Box(-1, 1, shape=(7,))— дельта 6D для конечного эффектора + захват 1D
Рекомендуемые эпизоды оценки
Для воспроизводимого бенчмаркинга используйте 10 эпизодов на задачу во всех четырёх стандартных наборах (Spatial, Object, Goal, Long). Это даёт 400 эпизодов в общей сложности и соответствует протоколу, использованному для опубликованных результатов. Показатели успеха могут отличаться на несколько процентов в зависимости от seed'ов оценки, поэтому мы рекомендуем усреднять результаты по 3 seed'ам.
lerobot-eval выводит 95% доверительный интервал Уилсона (pc_success_ci95) рядом с каждой оценкой успешности. При 10 эпизодах, если задача набрала 9 из 10, интервал составляет примерно от 60% до 98%, а для общего результата из 400 эпизодов при 80% он составляет примерно от 76% до 84%. Если интервалы двух политик пересекаются на какой-то задаче, это означает, что данный прогон не показал их различия на этой задаче. Интервал учитывает, какие именно эпизоды были отобраны; он не учитывает seed обучения политики, для оценки которого требуется более одного прогона обучения.
To compare two policies on the same episodes, use the same `--seed`, keep `--env.init_states=true`, and run each task in a single batch (`--eval.batch_size` equal to episodes per task).
Обучение
Набор данных
Два предварительно обработанных набора данных LIBERO полностью совместимы с LeRobot. Они содержат одни и те же демонстрации с одинаковой схемой и отличаются способом хранения кадров с камер:
| lerobot/libero | HuggingFaceVLA/libero | |
|---|---|---|
| эпизоды / кадры / задачи | 1,693 / 273,465 / 40 | 1,693 / 273,465 / 40 |
| камеры | 2× 256×256×3 | 2× 256×256×3 |
| размерности состояния / действия | 8 / 7 | 8 / 7 |
| формат набора данных | v3.0 | v3.0 |
| кодирование камеры | Видео MP4 | PNG в parquet |
| размер для загрузки | 1,9 ГБ | 69,9 ГБ |
| дополнительная зависимость | видео-бэкенд (torchcodec или pyav) | none |
Мы рекомендуем lerobot/libero: размер загрузки меньше в 37 раз при эквивалентной скорости загрузки (~330 образцов/с на воркер). Перекодирование видео слегка теряет качество; используйте вариант на основе изображений, если не можете установить бэкенд декодирования видео.
Для справки, исходный набор данных, опубликованный Physical Intelligence:
Pin `--dataset.revision=` when reporting results — Hub datasets can be re-uploaded, and success rates are only comparable against the same data revision.
Пример команды обучения
Обучите SmolVLA на рекомендуемом наборе данных:
lerobot-train \
  --policy.type=smolvla \
  --policy.load_vlm_weights=true \
  --policy.push_to_hub=false \
  --dataset.repo_id=lerobot/libero \
  --dataset.video_backend=torchcodec \
  --output_dir=./outputs/libero_smolvla \
  --steps=100000 \
  --batch_size=64
Чтобы опубликовать результат на Hub, замените --policy.push_to_hub=false на --policy.repo_id=${HF_USER}/libero-smolvla. Оцените сохранённые контрольные точки с помощью lerobot-eval, как показано в разделе Оценка.
Воспроизведение опубликованных результатов
Мы воспроизводим результаты Pi0.5 на бенчмарке LIBERO. Мы берём базовую модель LIBERO от Physical Intelligence (pi05_libero) и дообучаем её в течение дополнительных 6k шагов в bfloat16, с размером батча 256 на 8 GPU H100, используя датасет LIBERO от HuggingFace.
Дообученная модель: lerobot/pi05_libero_finetuned
Команда оценки
lerobot-eval \
  --output_dir=./eval_logs/ \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --policy.path=lerobot/pi05_libero_finetuned \
  --policy.n_action_steps=10 \
  --env.max_parallel_tasks=1
Мы задали n_action_steps=10, что соответствует исходной реализации OpenPI.
Результаты
| Модель | LIBERO Spatial | LIBERO Object | LIBERO Цель | LIBERO 10 | Среднее |
|---|---|---|---|---|---|
| Pi0.5 (LeRobot) | 97.0 | 99.0 | 98.0 | 96.0 | 97.5 |
Эти результаты согласуются с исходными результатами, опубликованными Physical Intelligence:
| Модель | LIBERO Spatial | LIBERO Object | LIBERO Цель | LIBERO 10 | Среднее |
|---|---|---|---|---|---|
| Pi0.5 (OpenPI) | 98.8 | 98.2 | 98.0 | 92.4 | 96.85 |