
LeRobot documentation
Meta-World
Meta-World
The commands below run the simulator locally. To keep its dependencies away from your policy's, serve it instead with `lerobot-env-server --config_path=docker/sim/configs/metaworld.yaml --sim.task=--docker=true`, where ` ` is the command's `--env.task`, and add `--env.server.endpoint=tcp/127.0.0.1:7448` to the command. A server runs the task it was started with (see [Simulation: local or served](./simulation)).
Meta-World é um benchmark de simulação de código aberto para aprendizado por reforço multi-tarefa e meta em manipulação robótica de controle contínuo. Ele reúne 50 tarefas de manipulação diversas usando objetos do dia a dia e um braço Sawyer de mesa comum, fornecendo um ambiente padronizado para testar se os algoritmos podem aprender muitas tarefas diferentes e generalizar rapidamente para novas.
- Artigo: Meta-World: Um benchmark e avaliação para aprendizado de reforço multi-tarefa e meta
- GitHub: Farama-Foundation/Metaworld
- Site do projeto: metaworld.farama.org
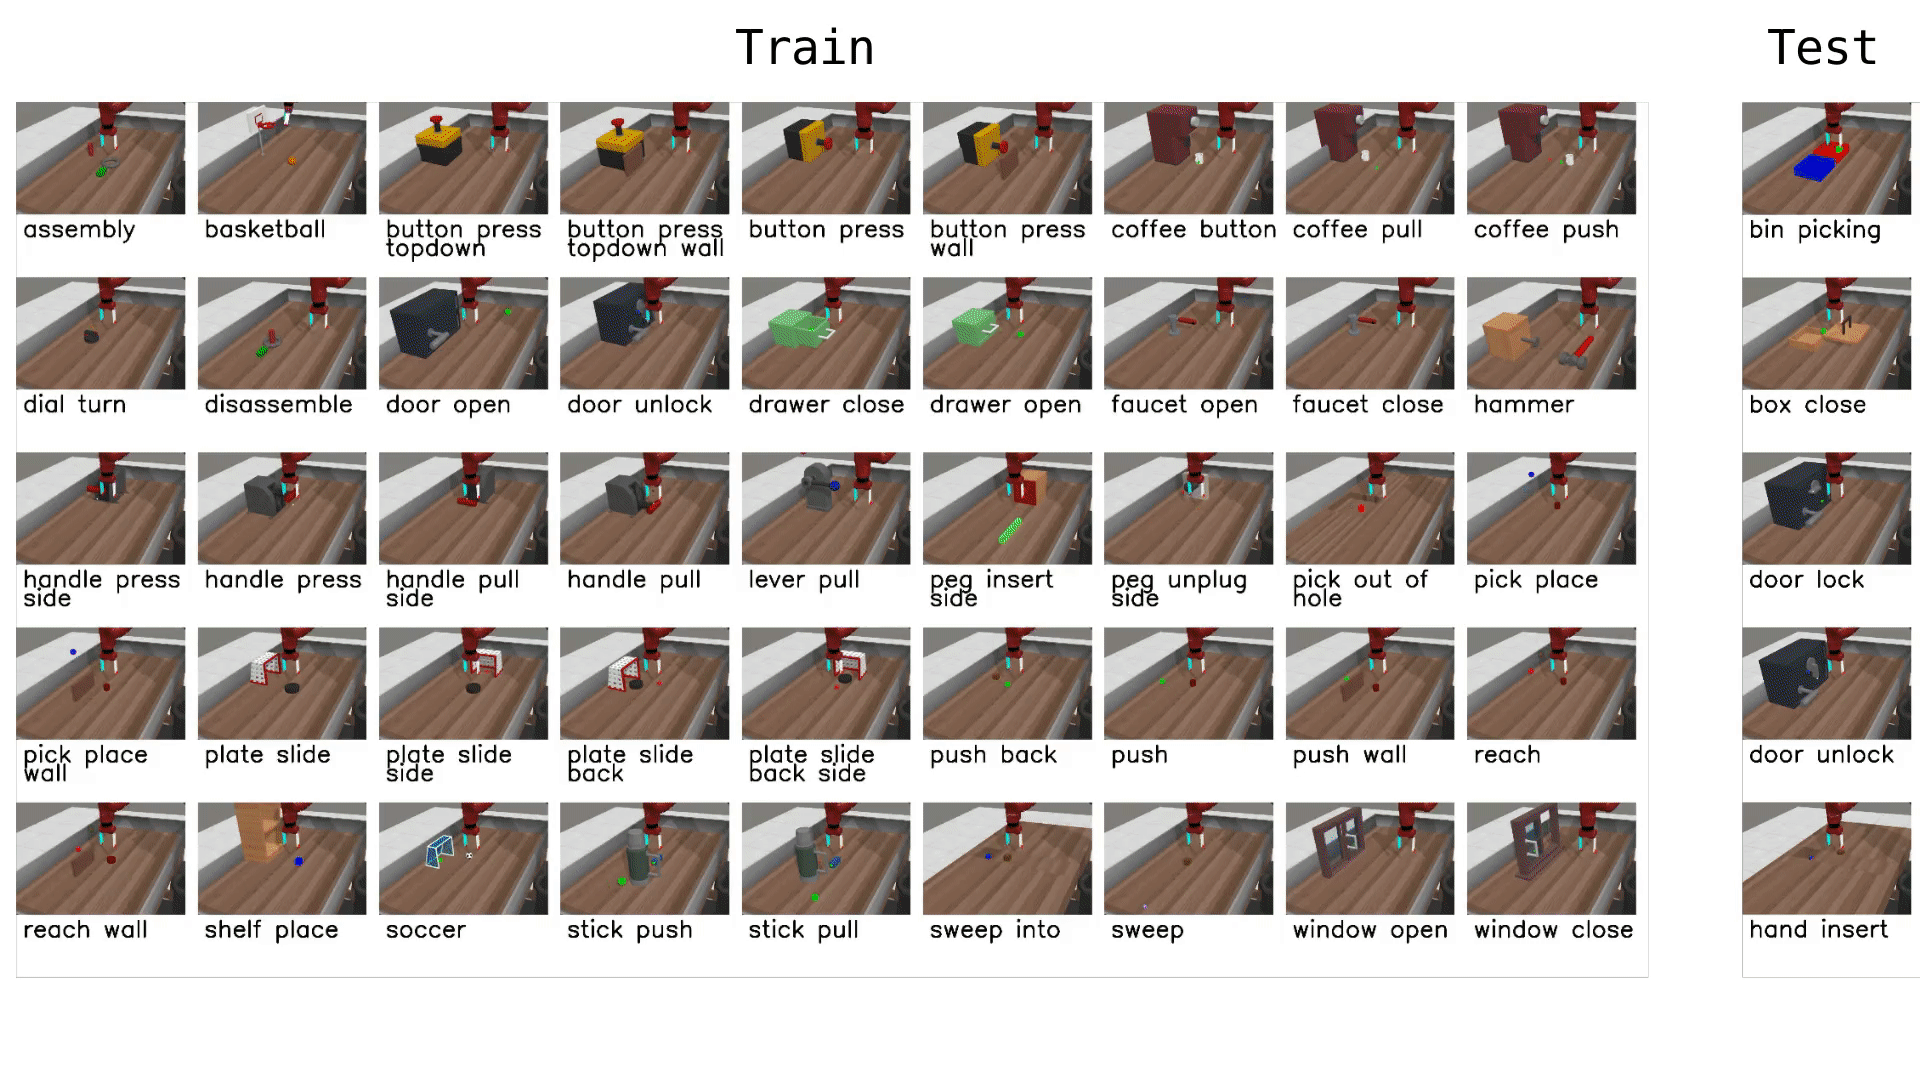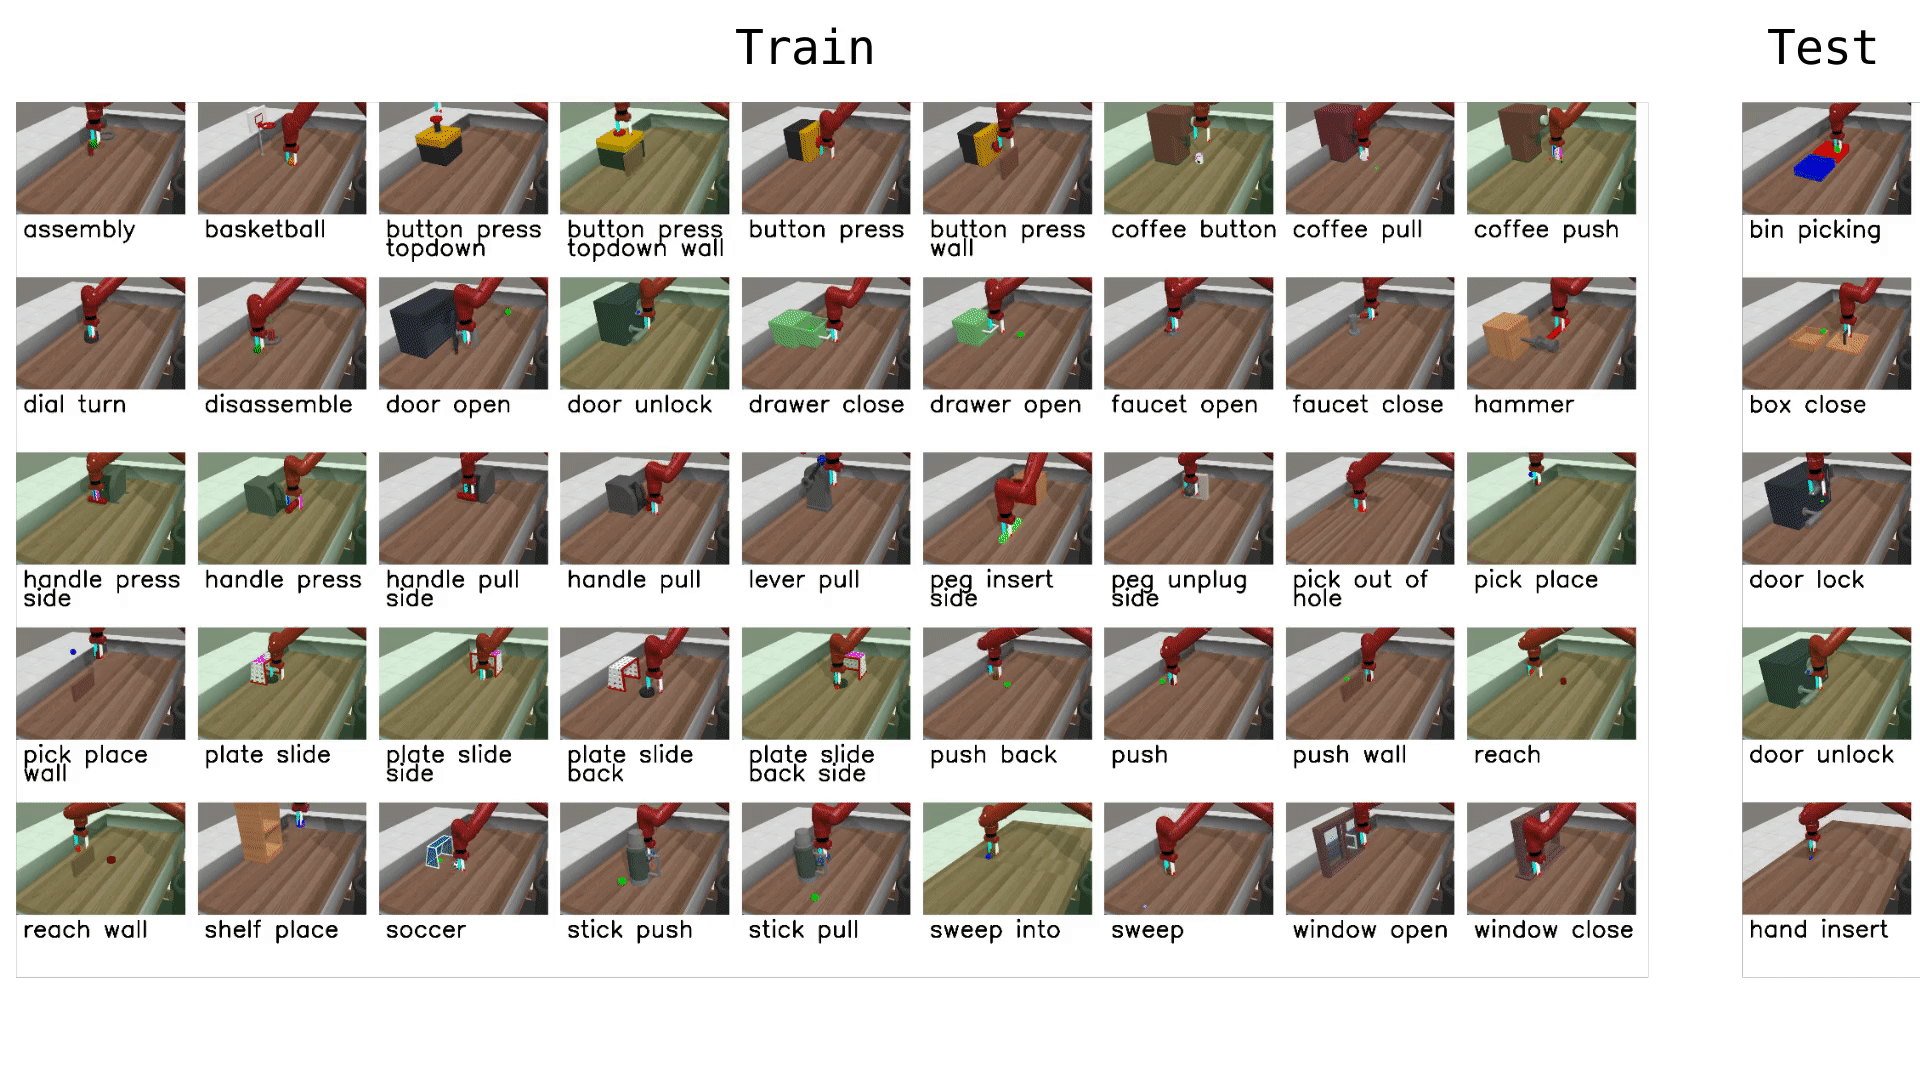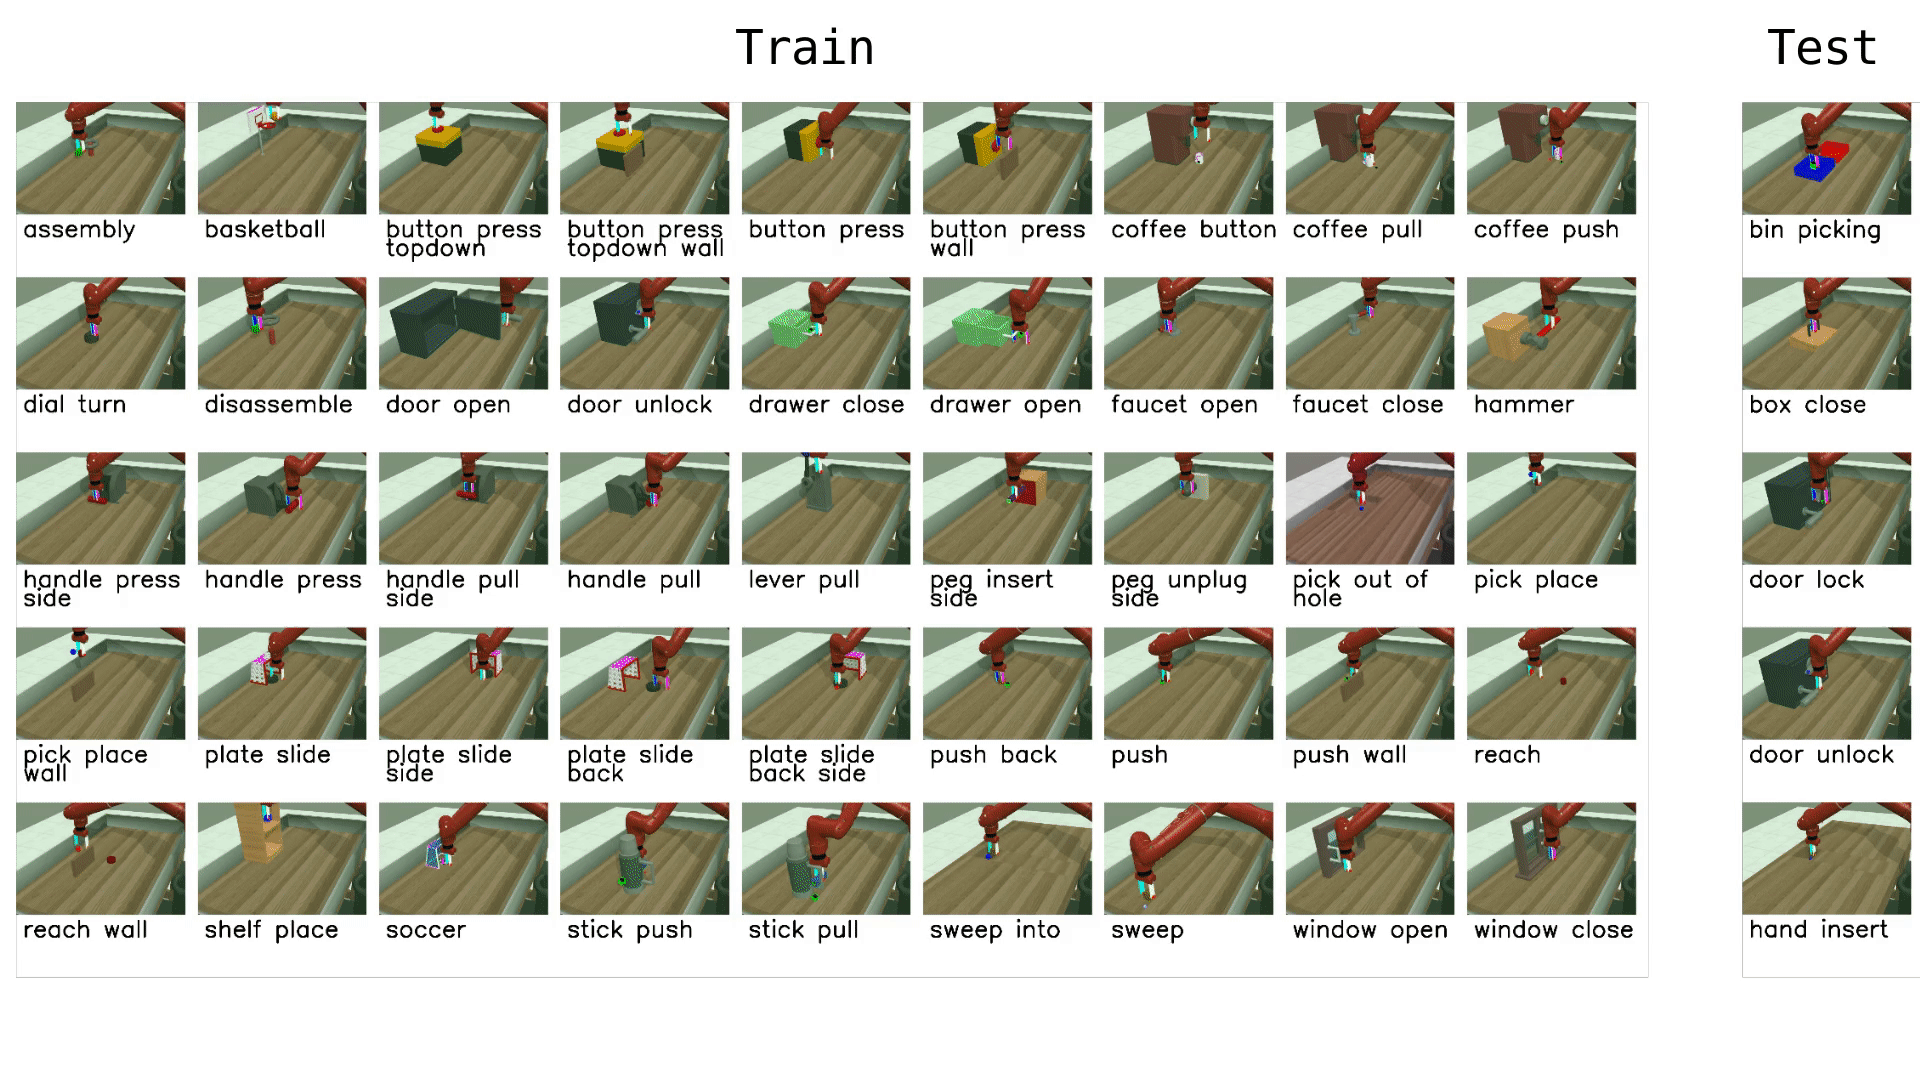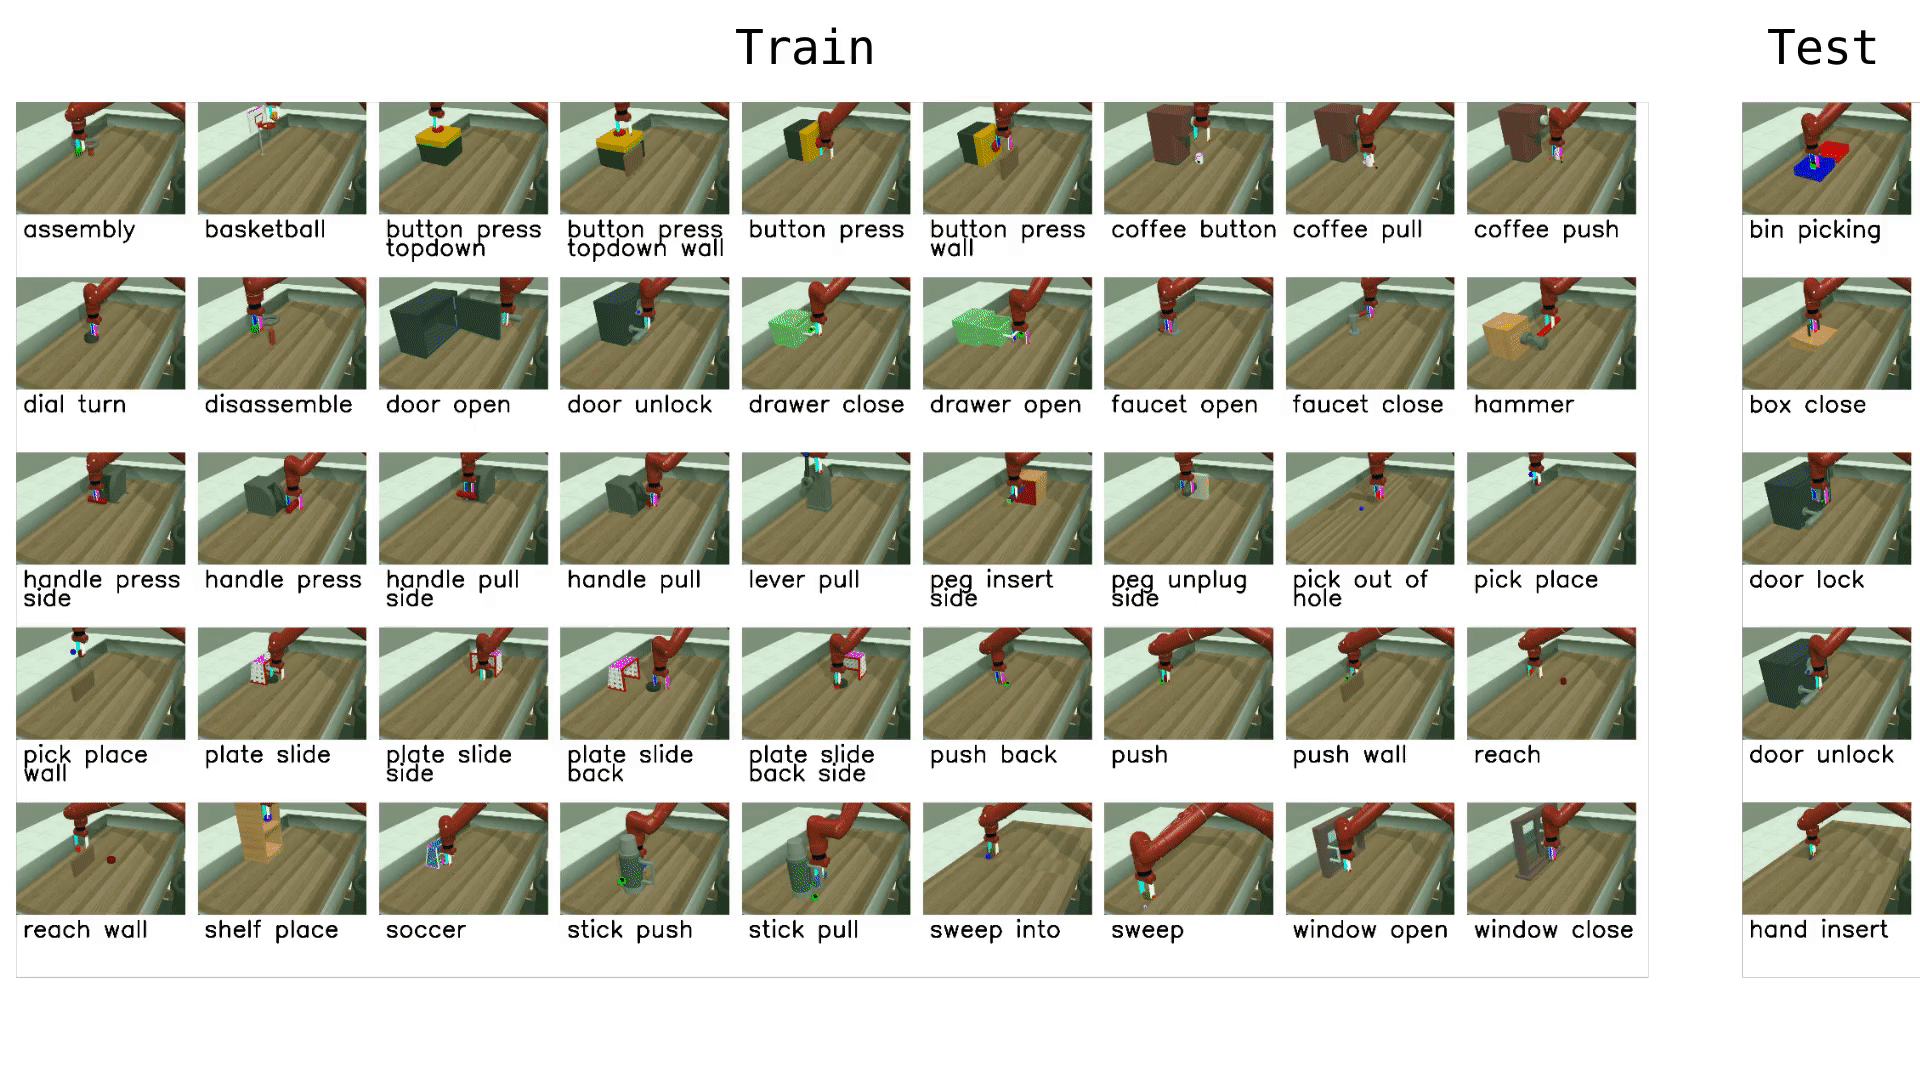
Tarefas disponíveis
O Meta-World fornece 50 tarefas organizadas em grupos de dificuldade. No LeRobot, você pode avaliar em tarefas individuais, grupos de dificuldade ou na suíte completa MT50:
| Grupo | Nome da CLI | Tarefas | Descrição |
|---|---|---|---|
| Fácil | easy | 28 | Tarefas com dinâmicas simples e objetivos de etapa única |
| Médio | medium | 11 | Tarefas que exigem raciocínio em múltiplas etapas |
| Difícil | hard | 6 | Tarefas com contatos complexos e manipulação precisa |
| Muito difícil | very_hard | 5 | As tarefas mais desafiadoras da suíte |
| MT50 (todos) | Lista separada por vírgulas | 50 | Todas as 50 tarefas — o cenário multitarefa mais desafiador |
Você também pode passar nomes de tarefas individuais diretamente (por exemplo, assembly-v3, dial-turn-v3).
Fornecemos um dataset pronto para LeRobot para o Meta-World MT50 no HF Hub: lerobot/metaworld_mt50. Este dataset está formatado para a avaliação do MT50, que utiliza todas as 50 tarefas com posições fixas de objetos/objetivos e vetores de tarefa one-hot para consistência.
Instalação
Após seguir as instruções de instalação do LeRobot:
pip install -e ".[metaworld]"If you encounter an `AssertionError: ['human', 'rgb_array', 'depth_array']` when running Meta-World environments, this is a mismatch between Meta-World and your Gymnasium version. Reinstall the Gymnasium version LeRobot supports (Meta-World `3.0.0` works with it):pip install "gymnasium>=1.1.1,<2.0.0"
Avaliação
Avaliação local padrão
Avalie no split de dificuldade média (um bom equilíbrio entre cobertura e computação):
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=metaworld \
  --env.task=medium \
  --eval.batch_size=1 \
  --eval.n_episodes=10
Avaliação de tarefa única
Avaliar em uma tarefa específica:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=metaworld \
  --env.task=assembly-v3 \
  --eval.batch_size=1 \
  --eval.n_episodes=10
Avaliação multi-tarefa
Avalie em várias tarefas ou grupos de dificuldade:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=metaworld \
  --env.task=assembly-v3,dial-turn-v3,handle-press-side-v3 \
  --eval.batch_size=1 \
--eval.n_episodes=10--env.taskaceita listas de tarefas explícitas (separadas por vírgula) ou grupos de dificuldade (por exemplo,easy,medium,hard,very_hard).--eval.batch_sizecontrola quantos ambientes são executados em paralelo.--eval.n_episodesdefine quantos episódios serão executados por tarefa.
Entradas e saídas da política
Observações:
observation.image— visão de uma única câmera (corner2), 480x480 HWC uint8observation.state— estado proprioceptivo de 4 dimensões (posição do efector final + garra)
Ações:
- Controle contínuo em
Box(-1, 1, shape=(4,))— efector final 3D + garra 1D
Episódios de avaliação recomendados
Para benchmarking reproduzível, use 10 episódios por tarefa. Para a suíte completa MT50, isso resulta em 500 episódios no total. Se você se preocupa com generalização, execute na MT50 completa — ela é intencionalmente desafiadora e revela melhor as forças e fraquezas do que algumas tarefas estreitas.
Treinamento
Exemplo de comando de treinamento
Treine uma política SmolVLA em um subconjunto de tarefas do Meta-World:
lerobot-train \
  --policy.type=smolvla \
  --policy.repo_id=${HF_USER}/metaworld-test \
  --policy.load_vlm_weights=true \
  --dataset.repo_id=lerobot/metaworld_mt50 \
  --env.type=metaworld \
  --env.task=assembly-v3,dial-turn-v3,handle-press-side-v3 \
  --output_dir=./outputs/ \
  --steps=100000 \
  --batch_size=4 \
  --eval.batch_size=1 \
  --eval.n_episodes=1 \
  --env_eval_freq=1000
Dicas práticas
- Use a condicionamento de tarefa one-hot para treinamento multitarefa (convenções MT10/MT50) para que as políticas tenham um contexto de tarefa explícito.
- Inspecione as descrições de tarefas do conjunto de dados e as chaves
info["is_success"]ao escrever o pós-processamento ou o registro para que suas métricas de sucesso estejam alinhadas com o benchmark. - Ajuste
batch_size,stepseenv_eval_freqpara corresponder ao seu orçamento de computação.