
LeRobot documentation
Meta-World
Meta-World
The commands below run the simulator locally. To keep its dependencies away from your policy's, serve it instead with `lerobot-env-server --config_path=docker/sim/configs/metaworld.yaml --sim.task=--docker=true`, where ` ` is the command's `--env.task`, and add `--env.server.endpoint=tcp/127.0.0.1:7448` to the command. A server runs the task it was started with (see [Simulation: local or served](./simulation)).
Meta-World est un benchmark de simulation open source pour l'apprentissage par renforcement multi-tâches et méta dans la manipulation robotique à contrôle continu. Il regroupe 50 tâches de manipulation variées utilisant des objets du quotidien et un bras Sawyer de table commun, offrant un terrain de jeu standardisé pour tester si les algorithmes peuvent apprendre de nombreuses tâches différentes et généraliser rapidement à de nouvelles tâches.
- Article : Meta-World: un benchmark et une évaluation pour l'apprentissage par renforcement multi-tâches et méta
- GitHub : Farama-Foundation/Metaworld
- Site web du projet : metaworld.farama.org
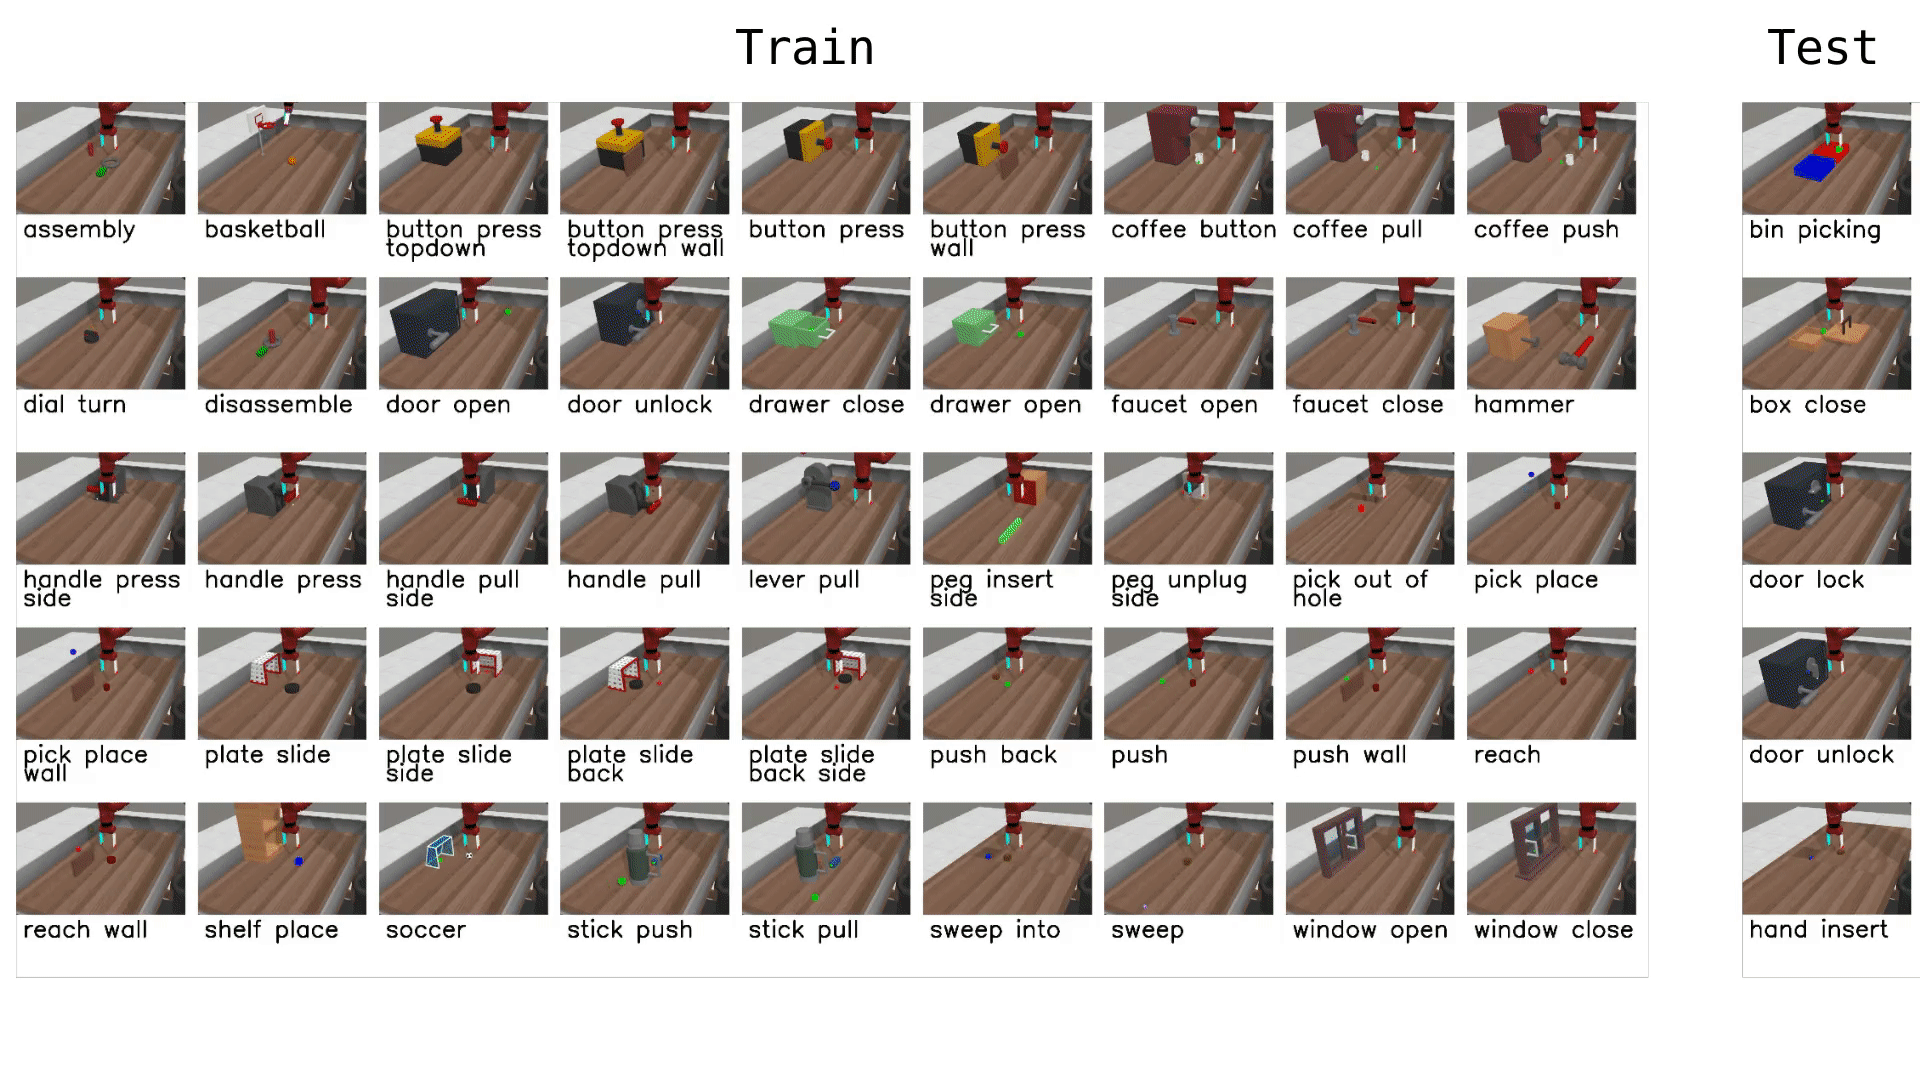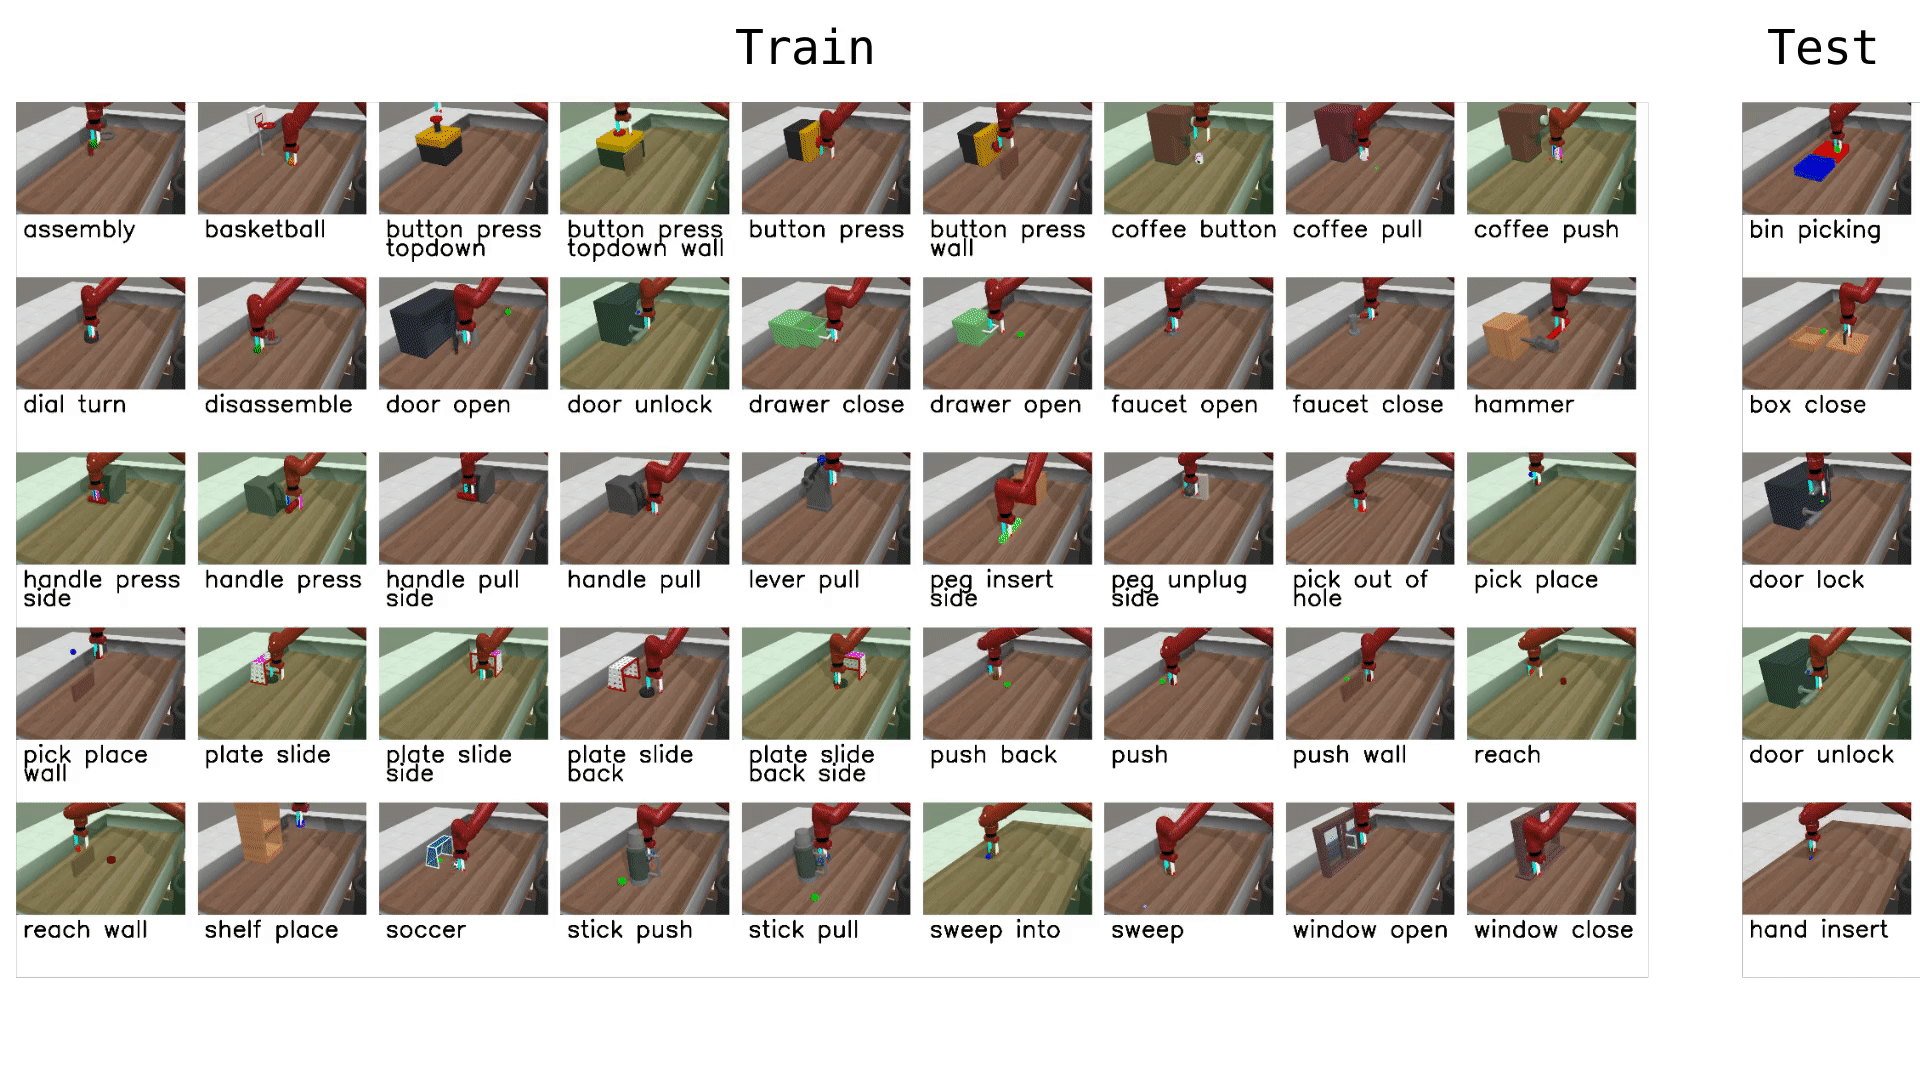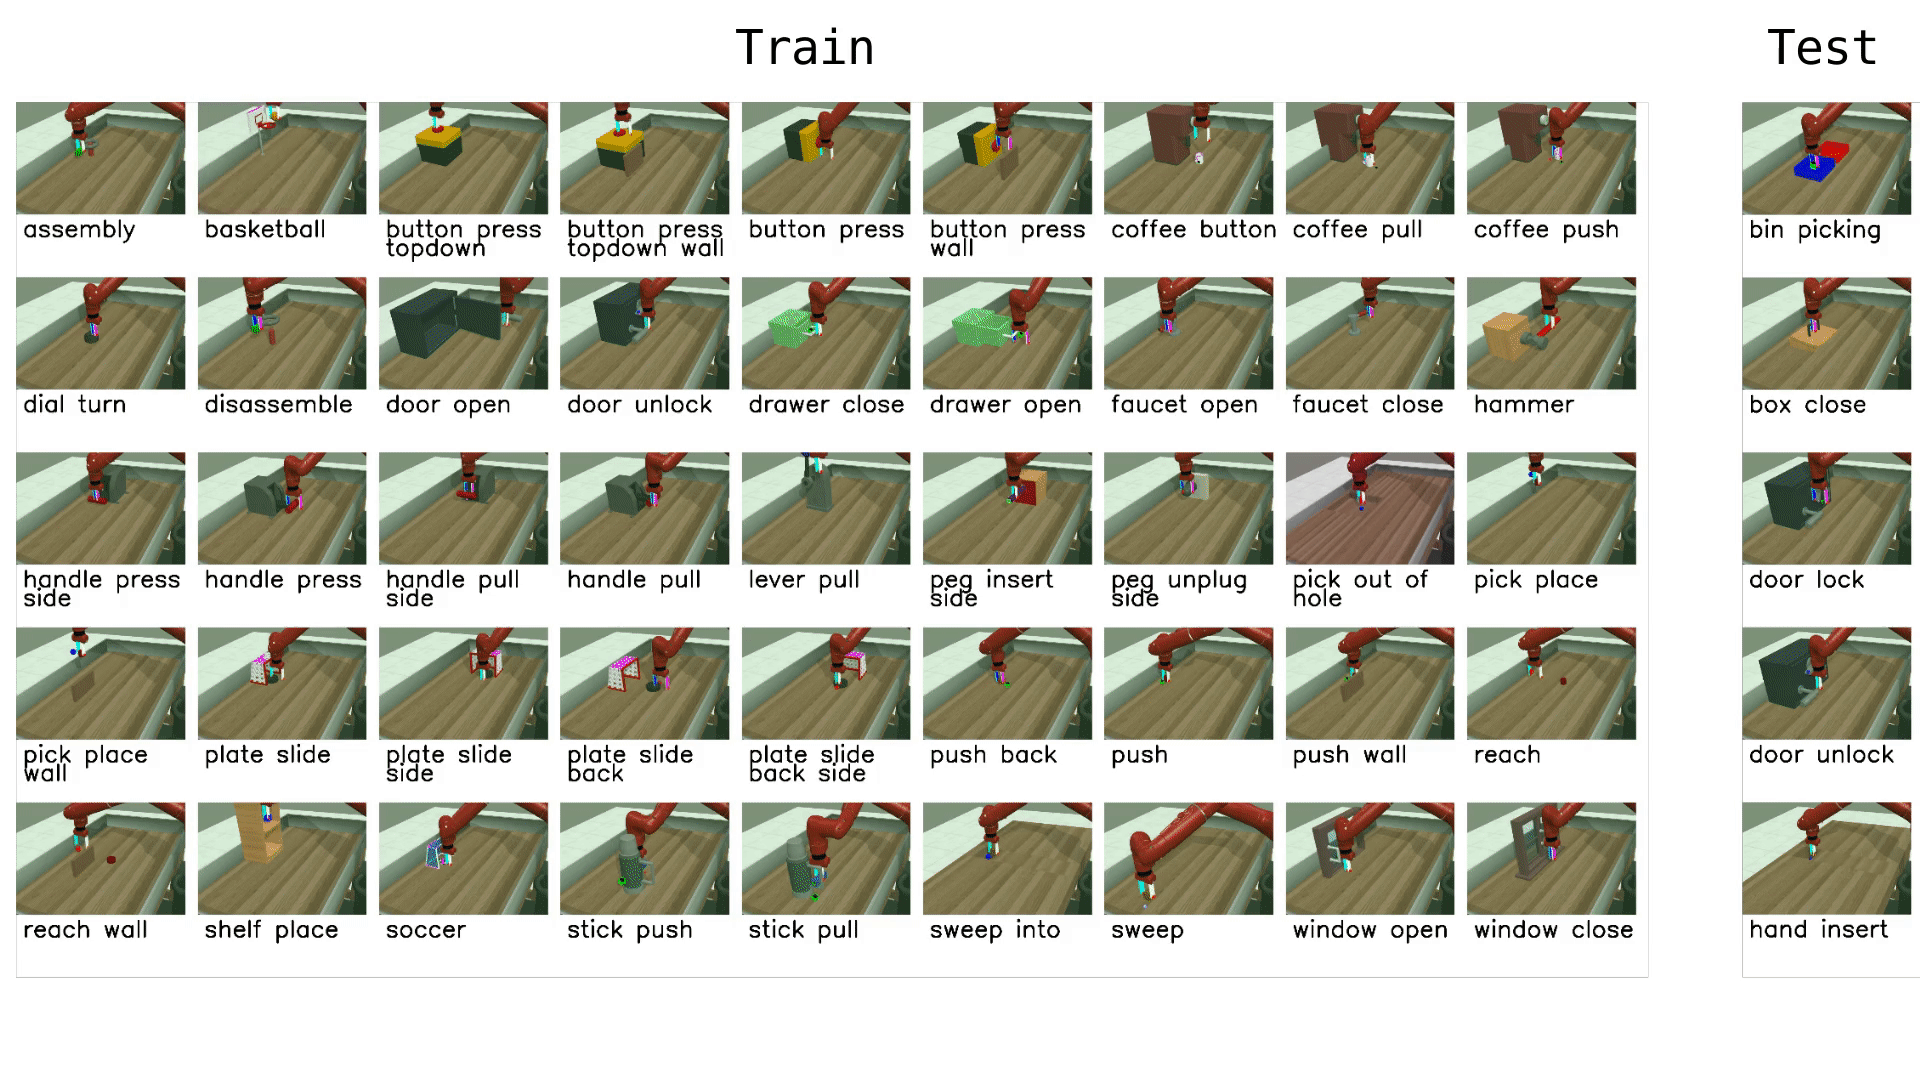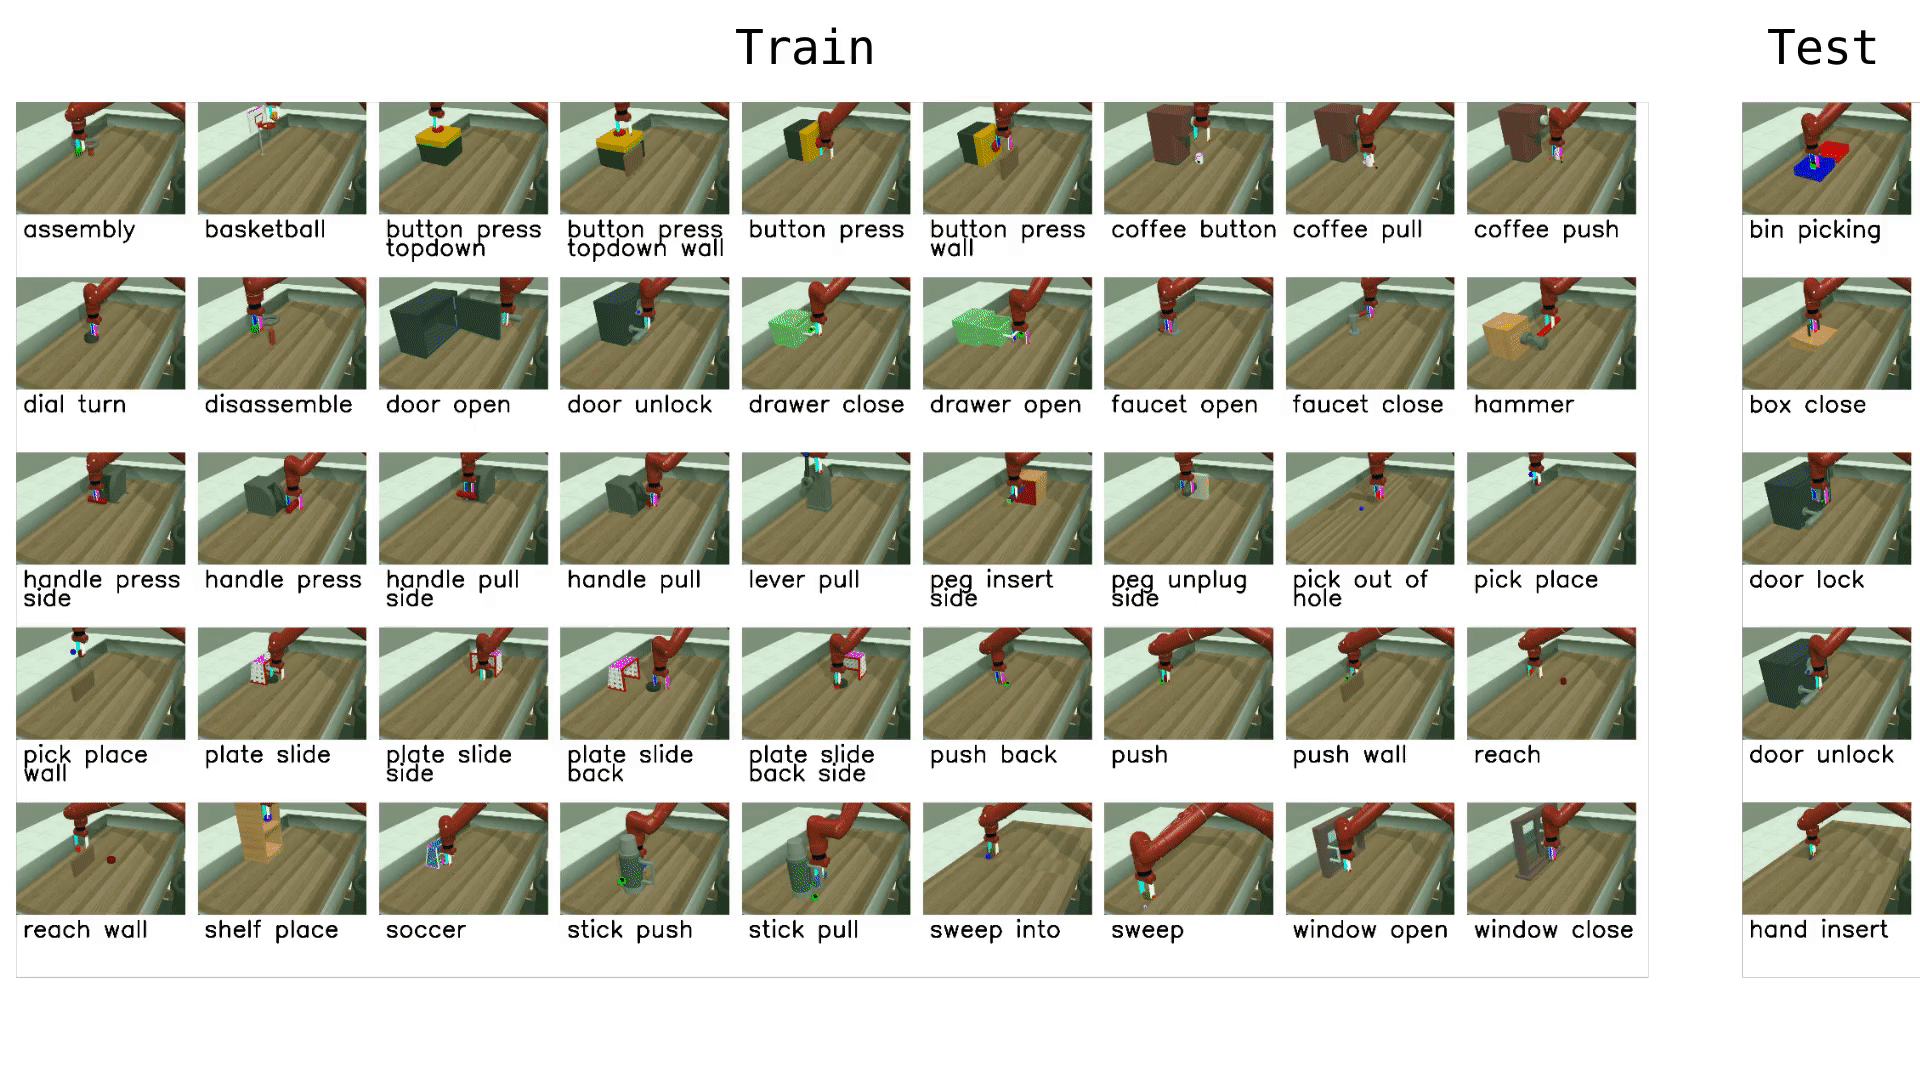
Tâches disponibles
Meta-World fournit 50 tâches organisées en groupes de difficulté. Dans LeRobot, vous pouvez évaluer sur des tâches individuelles, des groupes de difficulté ou la suite complète MT50 :
| Groupe | Nom de la CLI | Tâches | Description |
|---|---|---|---|
| Facile | easy | 28 | Tâches à dynamique simple et à objectif en une seule étape |
| Moyen | medium | 11 | Tâches nécessitant un raisonnement en plusieurs étapes |
| Difficile | hard | 6 | Tâches impliquant des contacts complexes et une manipulation précise |
| Très difficile | very_hard | 5 | Les tâches les plus difficiles de la suite |
| MT50 (tous) | Liste séparée par des virgules | 50 | Les 50 tâches — le scénario multi-tâches le plus exigeant |
Vous pouvez également passer directement des noms de tâches individuels (par exemple, assembly-v3, dial-turn-v3).
Nous mettons à disposition un jeu de données prêt pour LeRobot pour Meta-World MT50 sur le HF Hub : lerobot/metaworld_mt50. Ce jeu de données est formaté pour l'évaluation MT50, qui utilise les 50 tâches avec des positions d'objets/buts fixes et des vecteurs de tâches one-hot pour assurer la cohérence.
Installation
Après avoir suivi les instructions d'installation de LeRobot :
pip install -e ".[metaworld]"If you encounter an `AssertionError: ['human', 'rgb_array', 'depth_array']` when running Meta-World environments, this is a mismatch between Meta-World and your Gymnasium version. Reinstall the Gymnasium version LeRobot supports (Meta-World `3.0.0` works with it):pip install "gymnasium>=1.1.1,<2.0.0"
Évaluation
Évaluation locale par défaut
Évaluer sur le split de difficulté moyenne (un bon équilibre entre couverture et calcul) :
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=metaworld \
  --env.task=medium \
  --eval.batch_size=1 \
  --eval.n_episodes=10
Évaluation monotâche
Évaluer sur une tâche spécifique :
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=metaworld \
  --env.task=assembly-v3 \
  --eval.batch_size=1 \
  --eval.n_episodes=10
Évaluation multi-tâches
Évaluer sur plusieurs tâches ou groupes de difficulté :
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=metaworld \
  --env.task=assembly-v3,dial-turn-v3,handle-press-side-v3 \
  --eval.batch_size=1 \
--eval.n_episodes=10--env.taskaccepte des listes de tâches explicites (séparées par des virgules) ou des groupes de difficulté (par exemple,easy,medium,hard,very_hard).--eval.batch_sizecontrôle le nombre d'environnements exécutés en parallèle.--eval.n_episodesdéfinit le nombre d'épisodes à exécuter par tâche.
Entrées et sorties de la politique
Observations :
observation.image— vue d’une caméra unique (corner2), 480x480 HWC uint8observation.state— état proprioceptif de 4 dimensions (position de l'effecteur terminal + pince)
Actions :
- Contrôle continu dans
Box(-1, 1, shape=(4,))— effecteur final 3D delta + pince 1D
Épisodes d'évaluation recommandés
Pour un benchmarking reproductible, utilisez 10 épisodes par tâche. Pour la suite complète MT50, cela représente 500 épisodes au total. Si vous accordez de l'importance à la généralisation, exécutez sur la totalité de MT50 — elle est conçue pour être exigeante et met mieux en évidence les forces et les faiblesses que quelques tâches étroites.
Entraînement
Exemple de commande d'entraînement
Entraîner une politique SmolVLA sur un sous-ensemble de tâches Meta-World :
lerobot-train \
  --policy.type=smolvla \
  --policy.repo_id=${HF_USER}/metaworld-test \
  --policy.load_vlm_weights=true \
  --dataset.repo_id=lerobot/metaworld_mt50 \
  --env.type=metaworld \
  --env.task=assembly-v3,dial-turn-v3,handle-press-side-v3 \
  --output_dir=./outputs/ \
  --steps=100000 \
  --batch_size=4 \
  --eval.batch_size=1 \
  --eval.n_episodes=1 \
  --env_eval_freq=1000
Conseils pratiques
- Utilisez le conditionnement de tâche one-hot pour l’entraînement multi-tâches (conventions MT10/MT50) afin que les politiques disposent d’un contexte de tâche explicite.
- Inspectez les descriptions des tâches du jeu de données et les clés
info["is_success"]lors de l'écriture du post-traitement ou de la journalisation afin que vos métriques de réussite soient alignées avec le benchmark. - Ajustez
batch_size,stepsetenv_eval_freqpour qu’ils correspondent à votre budget de calcul.