
LeRobot documentation
Meta-World
Meta-World
The commands below run the simulator locally. To keep its dependencies away from your policy's, serve it instead with `lerobot-env-server --config_path=docker/sim/configs/metaworld.yaml --sim.task=--docker=true`, where ` ` is the command's `--env.task`, and add `--env.server.endpoint=tcp/127.0.0.1:7448` to the command. A server runs the task it was started with (see [Simulation: local or served](./simulation)).
Meta-World es un benchmark de simulación de código abierto para aprendizaje por refuerzo multi-tarea y meta en manipulación robótica de control continuo. Incluye 50 tareas de manipulación diversas que utilizan objetos cotidianos y un brazo Sawyer de mesa común, proporcionando un entorno estandarizado para probar si los algoritmos pueden aprender muchas tareas diferentes y generalizar rápidamente a nuevas.
- Artículo: Artículo: Meta-World: un benchmark y una evaluación para el aprendizaje por refuerzo multi-tarea y meta
- GitHub: Farama-Foundation/Metaworld
- Sitio web del proyecto: metaworld.farama.org
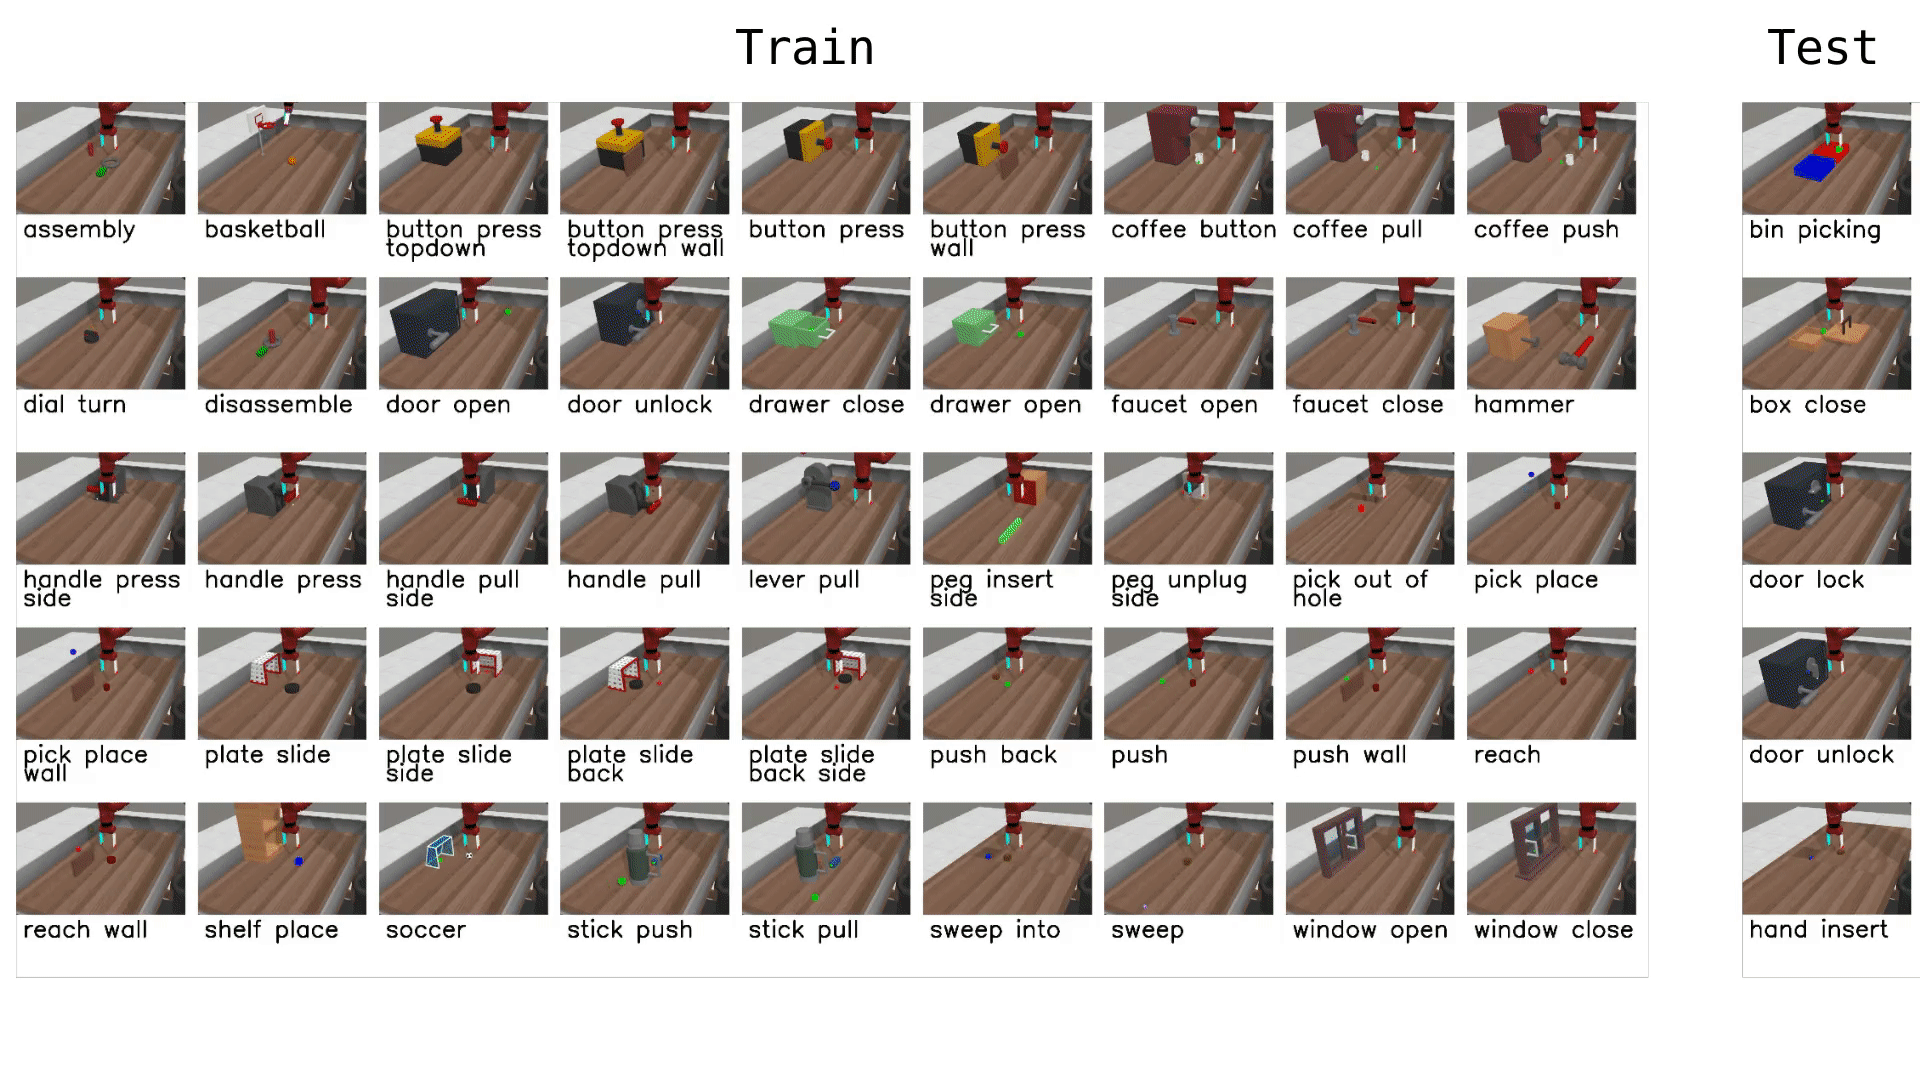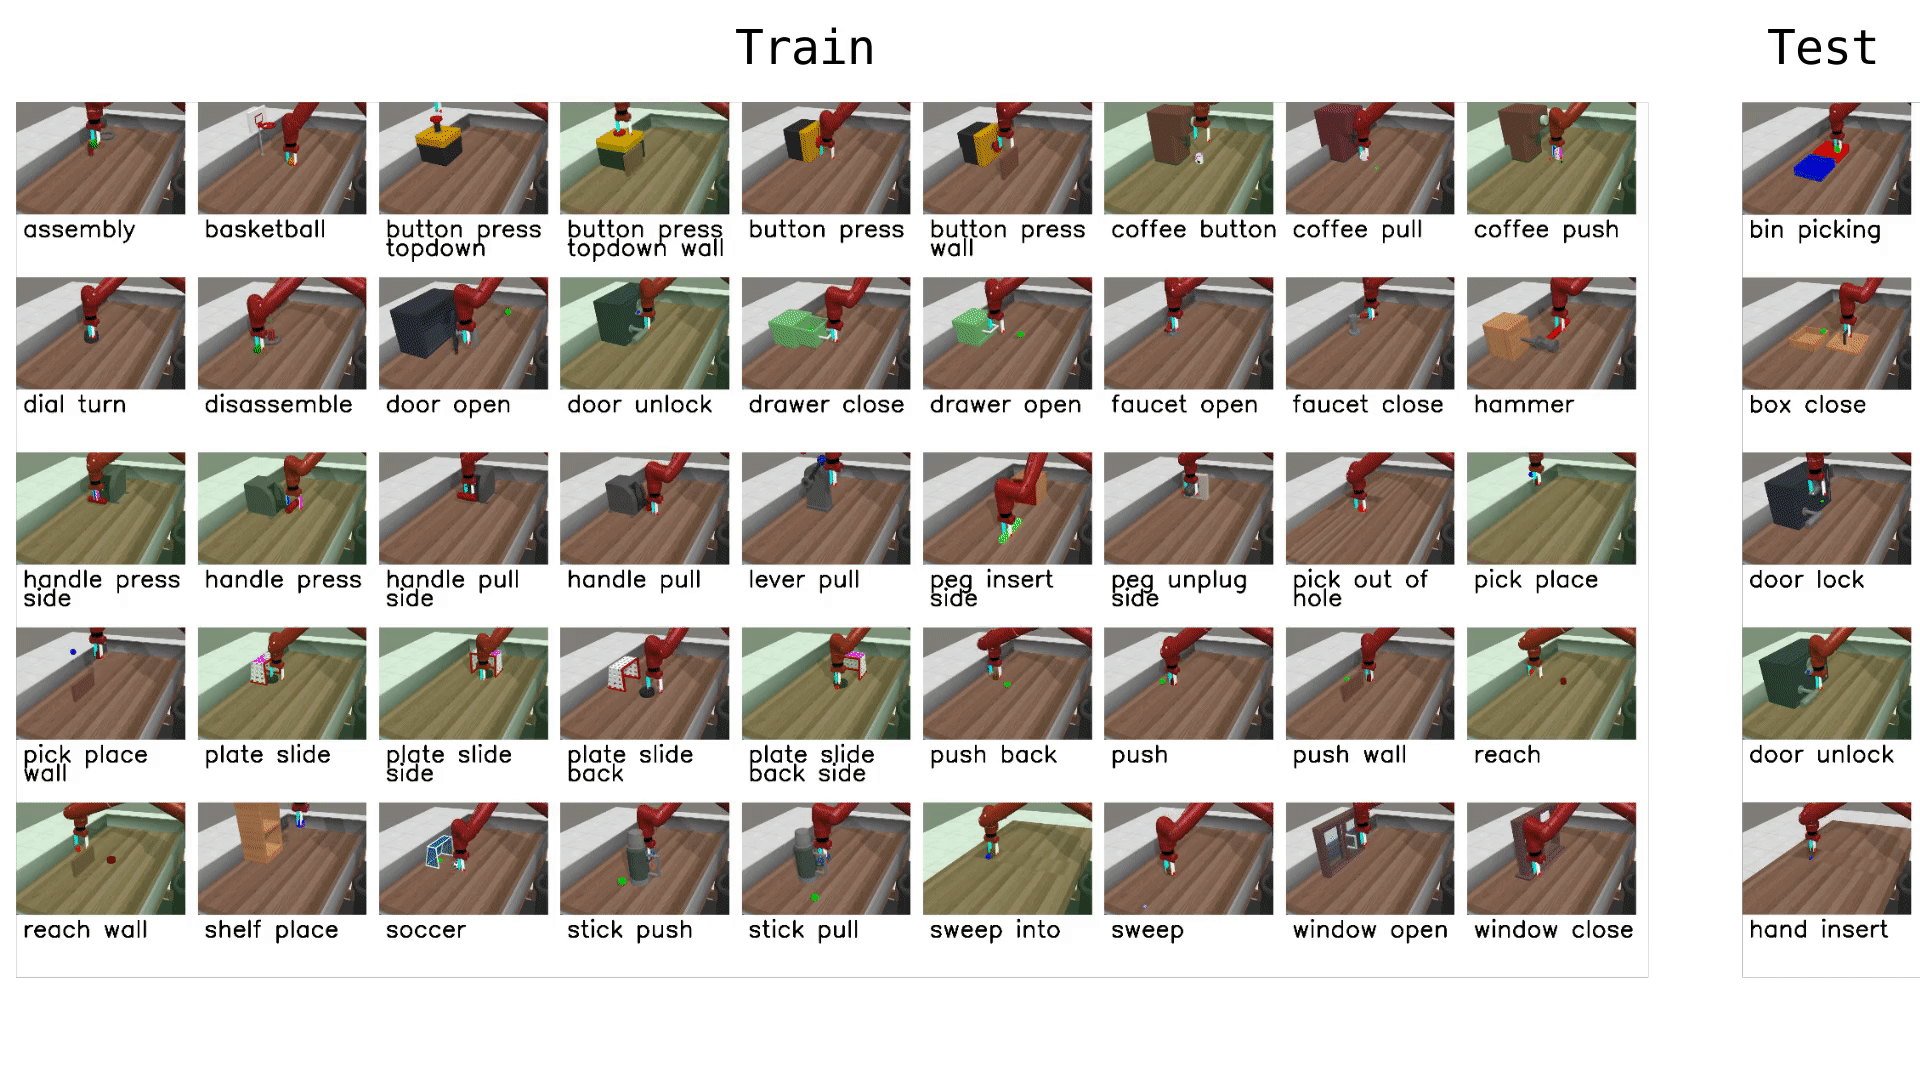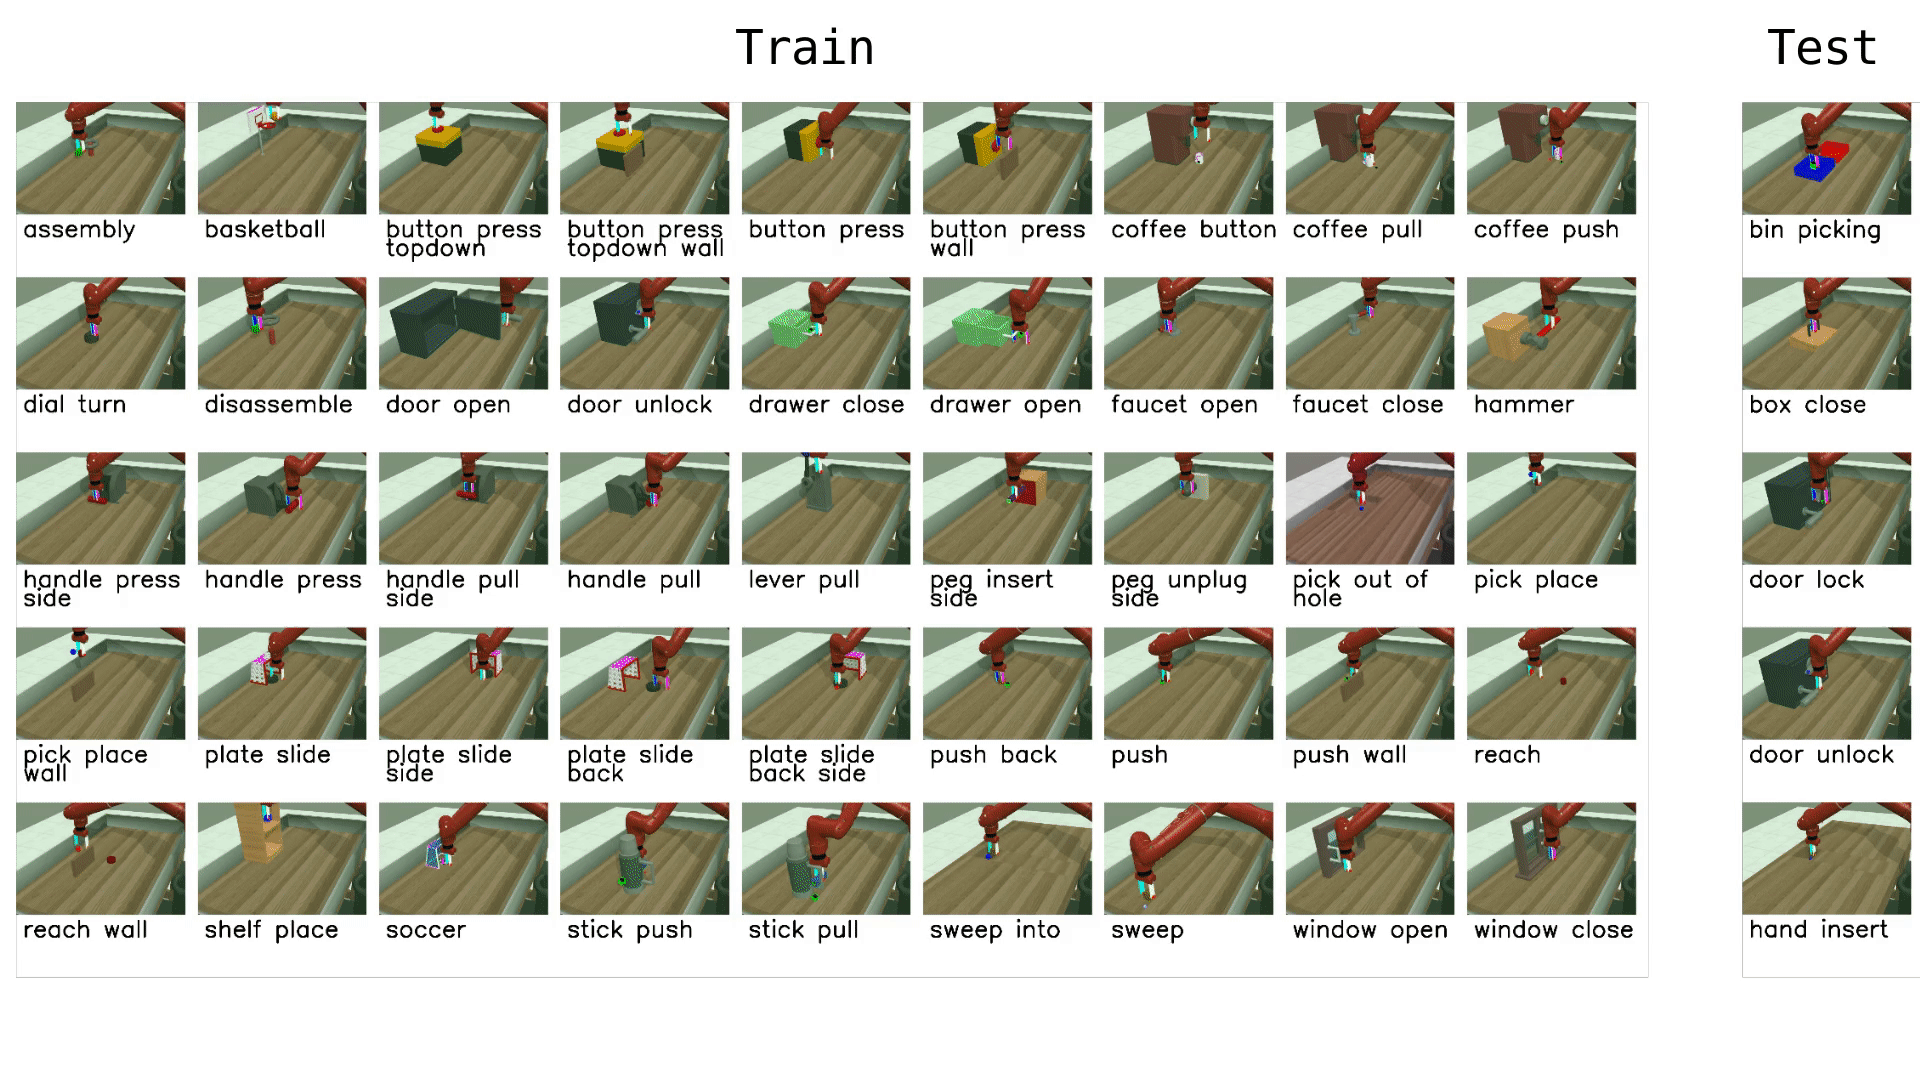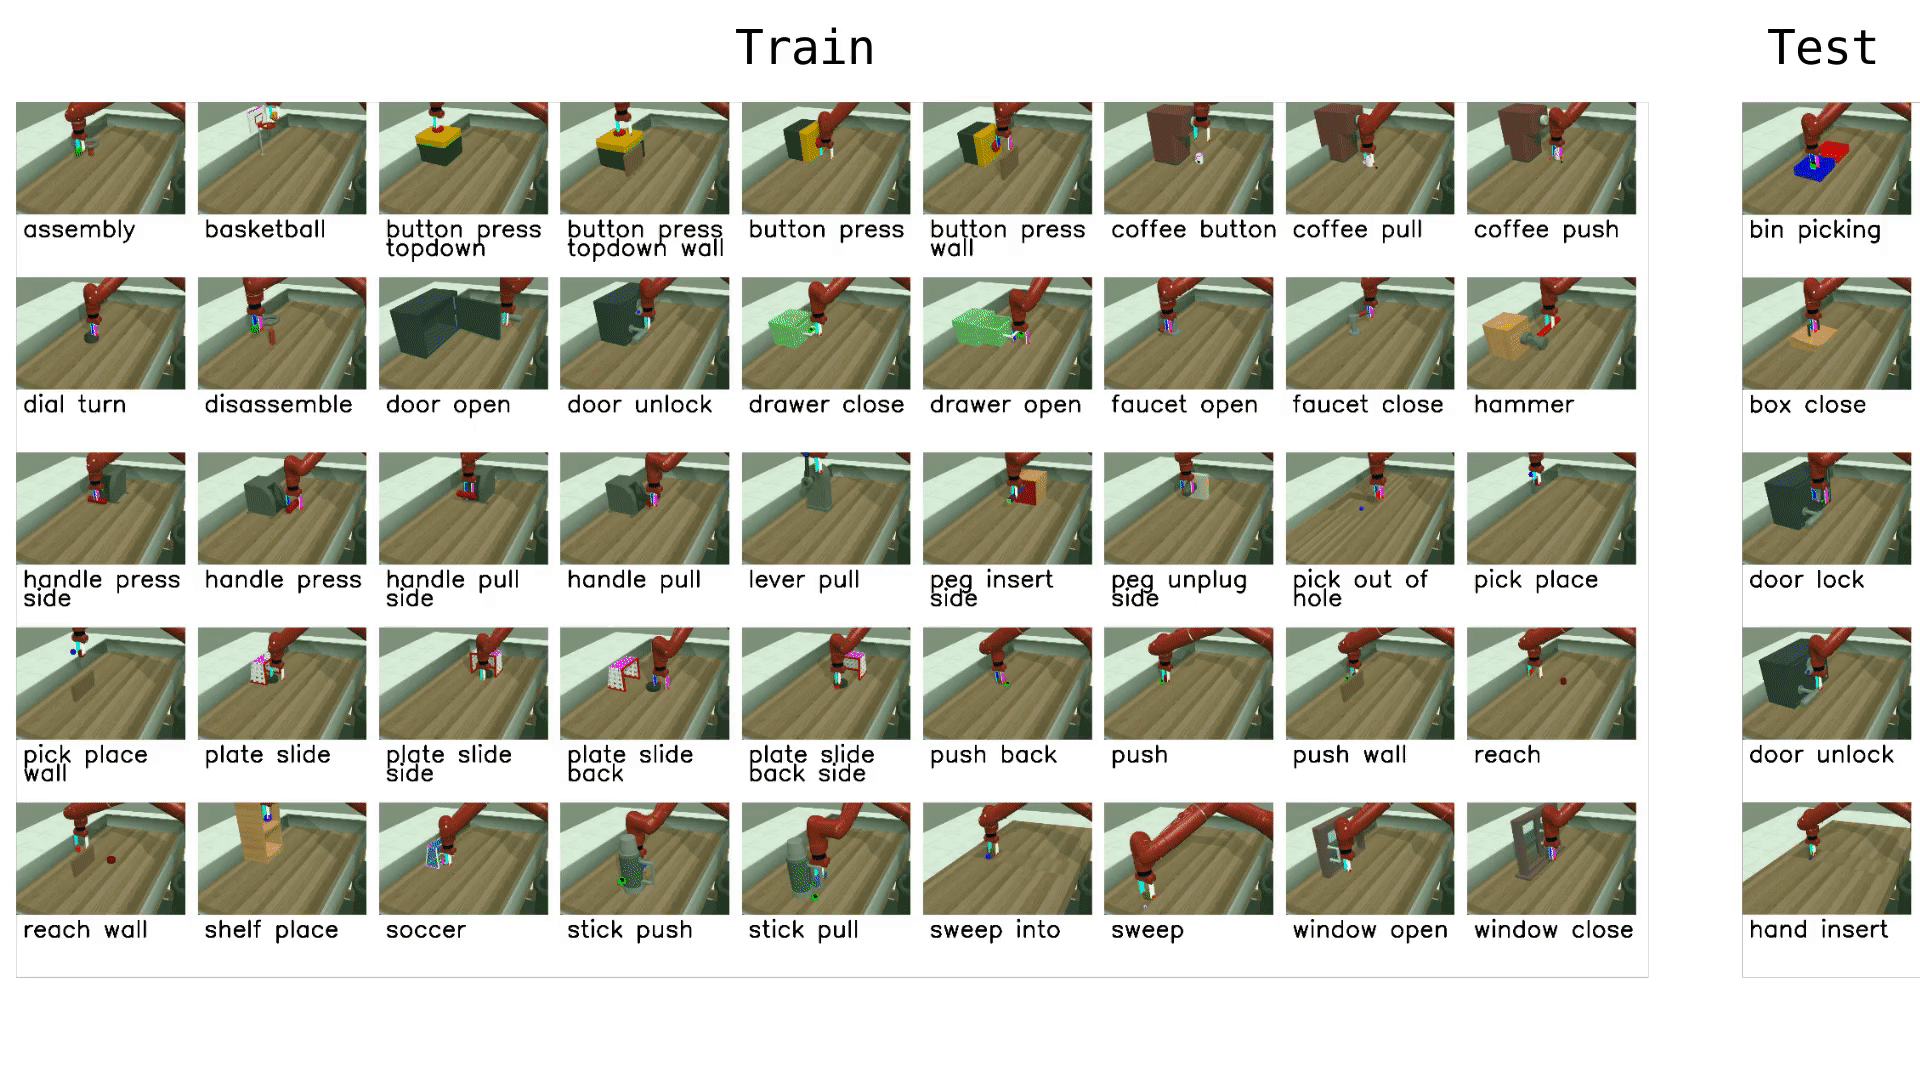
Tareas disponibles
Meta-World proporciona 50 tareas organizadas en grupos de dificultad. En LeRobot, puedes evaluar en tareas individuales, grupos de dificultad o la suite completa MT50:
| Grupo | Nombre de la CLI | Tareas | Descripción |
|---|---|---|---|
| Fácil | easy | 28 | Tareas con dinámicas simples y objetivos de un solo paso |
| Medio | medium | 11 | Tareas que requieren razonamiento en varios pasos |
| Difícil | hard | 6 | Tareas con contactos complejos y manipulación precisa |
| Muy difícil | very_hard | 5 | Las tareas más desafiantes de la suite |
| MT50 (todos) | Lista separada por comas | 50 | Las 50 tareas: la configuración multitarea más desafiante |
También puede pasar nombres de tareas individuales directamente (p. ej., assembly-v3, dial-turn-v3).
Proporcionamos un conjunto de datos listo para LeRobot para Meta-World MT50 en HF Hub: lerobot/metaworld_mt50. Este conjunto de datos está formateado para la evaluación de MT50, que utiliza las 50 tareas con posiciones de objeto/objetivo fijas y vectores de tarea one-hot para garantizar la consistencia.
Instalación
Tras seguir las instrucciones de instalación de LeRobot:
pip install -e ".[metaworld]"If you encounter an `AssertionError: ['human', 'rgb_array', 'depth_array']` when running Meta-World environments, this is a mismatch between Meta-World and your Gymnasium version. Reinstall the Gymnasium version LeRobot supports (Meta-World `3.0.0` works with it):pip install "gymnasium>=1.1.1,<2.0.0"
Evaluación
Evaluación local predeterminada
Evalúe en la división de dificultad media (un buen equilibrio entre cobertura y cómputo):
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=metaworld \
  --env.task=medium \
  --eval.batch_size=1 \
  --eval.n_episodes=10
Evaluación de una sola tarea
Evaluar en una tarea específica:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=metaworld \
  --env.task=assembly-v3 \
  --eval.batch_size=1 \
  --eval.n_episodes=10
Evaluación multitarea
Evaluar en varias tareas o grupos de dificultad:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=metaworld \
  --env.task=assembly-v3,dial-turn-v3,handle-press-side-v3 \
  --eval.batch_size=1 \
--eval.n_episodes=10--env.taskacepta listas de tareas explícitas (separadas por comas) o grupos de dificultad (p. ej.,easy,medium,hard,very_hard).--eval.batch_sizecontrola cuántos entornos se ejecutan en paralelo.--eval.n_episodesdefine cuántos episodios se ejecutan por tarea.
Entradas y salidas de la política
Observaciones:
observation.image— vista de una sola cámara (corner2), 480x480 HWC uint8observation.state— estado propioceptivo de 4 dimensiones (posición del efector final + pinza)
Acciones:
- Control continuo en
Box(-1, 1, shape=(4,))— delta de efector final 3D + pinza 1D
Episodios de evaluación recomendados
Para un benchmarking reproducible, use 10 episodios por tarea. Para el conjunto completo de MT50, esto da un total de 500 episodios. Si le interesa la generalización, ejecute en el MT50 completo: está diseñado para ser desafiante y revela mejor las fortalezas y debilidades que unas pocas tareas estrechas.
Entrenamiento
Ejemplo de comando de entrenamiento
Entrena una política SmolVLA en un subconjunto de tareas de Meta-World:
lerobot-train \
  --policy.type=smolvla \
  --policy.repo_id=${HF_USER}/metaworld-test \
  --policy.load_vlm_weights=true \
  --dataset.repo_id=lerobot/metaworld_mt50 \
  --env.type=metaworld \
  --env.task=assembly-v3,dial-turn-v3,handle-press-side-v3 \
  --output_dir=./outputs/ \
  --steps=100000 \
  --batch_size=4 \
  --eval.batch_size=1 \
  --eval.n_episodes=1 \
  --env_eval_freq=1000
Consejos prácticos
- Use la condición de tarea one-hot para el entrenamiento multitarea (convenciones MT10/MT50) para que las políticas tengan un contexto de tarea explícito.
- Inspecciona las descripciones de tareas del conjunto de datos y las claves
info["is_success"]al escribir el posprocesamiento o el registro para que tus métricas de éxito coincidan con el benchmark. - Ajusta
batch_size,stepsyenv_eval_freqpara que se ajusten a tu presupuesto de cómputo.