# Perceiver
## نظرة عامة
قُدم نموذج Perceiver IO في [Perceiver IO: A General Architecture for Structured Inputs & Outputs](https://huggingface.co/papers/2107.14795) بواسطة Andrew Jaegle وSebastian Borgeaud وJean-Baptiste Alayrac وCarl Doersch وCatalin Ionescu وDavid Ding وSkanda Koppula وDaniel Zoran وAndrew Brock وEvan Shelhamer وOlivier Hénaff وMatthew M. Botvinick وAndrew Zisserman وOriol Vinyals وJoão Carreira.
Perceiver IO هو تعميم لـ [Perceiver](https://huggingface.co/papers/2103.03206) للتعامل مع مخرجات غير محددة بالإضافة إلى مدخلات غير محددة. كان Perceiver الأصلي ينتج فقط تسمية تصنيف واحدة. بالإضافة إلى تسميات التصنيف، يمكن لـ Perceiver IO أن ينتج (على سبيل المثال) لغة، وتدفقًا بصريًا، وفيديوهات متعددة الوسائط مع صوت. يتم ذلك باستخدام نفس المكونات الأساسية المستخدمة في Perceiver الأصلي. التعقيد الحسابي لـ Perceiver IO خطي بالنسبة لحجم المدخلات والمخرجات، وتحدث معظم عمليات المعالجة في الفضاء الكامن، مما يتيح لنا معالجة مدخلات ومخرجات أكبر بكثير مما يمكن للـ Transformers القياسية التعامل معه. وهذا يعني، على سبيل المثال، أن Perceiver IO يمكنه تنفيذ نمذجة لغة مقنّعة بأسلوب BERT مباشرةً باستخدام البايتات بدلاً من المدخلات المُرمّزة.
المستخلص من الورقة البحثية هو كالتالي:
*يحقق نموذج Perceiver الذي تم اقتراحه مؤخرًا نتائج جيدة في عدة مجالات (الصور، الصوت، متعدد الوسائط، سحابة النقاط) مع التوسع خطيًا في الحساب والذاكرة مع حجم الإدخال. وعلى الرغم من أن Perceiver يدعم أنواعًا عديدة من المدخلات، إلا أنه لا يمكنه إنتاج مخرجات معقدة جدًا مثل درجات التصنيف. يتجاوز Perceiver IO هذا القيد دون التضحية بالخصائص الجذابة للنموذج الأصلي من خلال تعلم الاستعلام المرن عن الفضاء الكامن للنموذج لإنتاج مخرجات بحجم ودلالات تعسفية. لا يزال Perceiver IO يفصل عمق النموذج عن حجم البيانات ولا يزال يتوسع خطيًا مع حجم البيانات، ولكن الآن بالنسبة لحجمي الإدخال والإخراج معًا. يحقق نموذج Perceiver IO الكامل نتائج قوية في المهام ذات فضاءات المخرجات عالية البنية، مثل اللغة الطبيعية والفهم البصري، وStarCraft II، والمجالات متعددة المهام ومتعددة الوسائط. ومن أبرز النتائج، يطابق Perceiver IO خط الأساس BERT القائم على Transformer في معيار GLUE اللغوي دون الحاجة إلى تقسيم المدخلات إلى رموز، ويحقق أداءً متقدمًا في تقدير التدفق الضوئي في Sintel.*
إليك ملخص موجز يوضح آلية عمل Perceiver:
المشكلة الرئيسية في آلية الانتباه الذاتي (self-attention) في نموذج Transformer هي أن متطلبات الوقت والذاكرة تتناسب تناسبًا تربيعيًا مع طول التسلسل. ومن ثم، فإن النماذج مثل BERT وRoBERTa محدودة بطول تسلسل أقصى يبلغ 512 رمزًا. يهدف Perceiver إلى حل هذه المشكلة من خلال تنفيذ الانتباه الذاتي على مجموعة من المتغيرات الكامنة (latent variables) بدلاً من تنفيذها على المدخلات، واستخدام المدخلات فقط للانتباه المتقاطع (cross-attention). وبهذه الطريقة، لم تعد متطلبات الوقت والذاكرة تعتمد على طول المدخلات، حيث يتم استخدام كمية ثابتة من المتغيرات الكامنة، مثل 256 أو 512. يتم تهيئة هذه المتغيرات عشوائيًا، ثم يتم تدريبها من البداية إلى النهاية باستخدام الانتشار العكسي (backpropagation).
داخليًا، سيقوم [PerceiverModel](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverModel) بإنشاء المتغيرات الكامنة (latents)، وهي متجه (tensor) على شكل `(batch_size, num_latents, d_latents)`. يجب تقديم `inputs` (قد تكون نصوصًا أو صورًا أو صوتًا، أو أي شيء آخر!) إلى النموذج، والذي سيستخدمها لأداء الانتباه المتقاطع (cross-attention) مع المتغيرات الكامنة. يكون ناتج مشفر Perceiver متجهًا بنفس الشكل. ثم يمكن، على غرار BERT، تحويل الحالات المخفية الأخيرة للمتغيرات الكامنة إلى قيم تصنيف (classification logits) عن طريق أخذ المتوسط على بُعد التسلسل، ووضع طبقة خطية فوق ذلك لإسقاط `d_latents` إلى `num_labels`.
كانت هذه فكرة ورقة Perceiver الأصلية. غير أنها كانت لا تستطيع سوى إخراج قيم التصنيف (classification logits). في عمل لاحق، PerceiverIO، عمّموا الفكرة للسماح للنموذج أيضاً بإنتاج مخرجات بحجم تعسفي. كيف ذلك، كما قد تسألون؟ الفكرة في الواقع بسيطة نسبياً: يُعرَّف مخرجات بحجم تعسفي، ثم يُطبَّق الانتباه المتقاطع (cross-attention) مع الحالات المخفية الأخيرة للكائنات الكامنة (latents)، باستخدام المخرجات كاستعلامات (queries)، والكائنات الكامنة كمفاتيح وقيم (keys and values).
لنفترض إذن أن المرء يريد تنفيذ نمذجة اللغة المقنّعة (على غرار BERT) باستخدام Perceiver. وبما أن طول مدخلات Perceiver لن يؤثر على زمن حساب طبقات الانتباه الذاتي، يمكن تقديم البايتات الخام، بحيث تكون `inputs` المقدمة إلى النموذج بطول 2048. وإذا قُنعّعت الآن بعض هذه الرموز الـ 2048، يمكن تعريف `outputs` على أنها ذات الشكل: `(batch_size, 2048, 768)`. ثم يُنفَّذ الانتباه المتقاطع مع الحالات المخفية النهائية للكائنات الكامنة لتحديث متجه `outputs`. وبعد الانتباه المتقاطع، لا يزال لدينا متجه ذو الشكل `(batch_size, 2048, 768)`. يمكن بعد ذلك وضع رأس نمذجة لغة عادي في الأعلى، لإسقاط البُعد الأخير إلى حجم مفردات النموذج، أي إنشاء قيم logits ذات الشكل `(batch_size, 2048, 262)` (حيث يستخدم Perceiver حجم مفردات يبلغ 262 معرّف بايت).
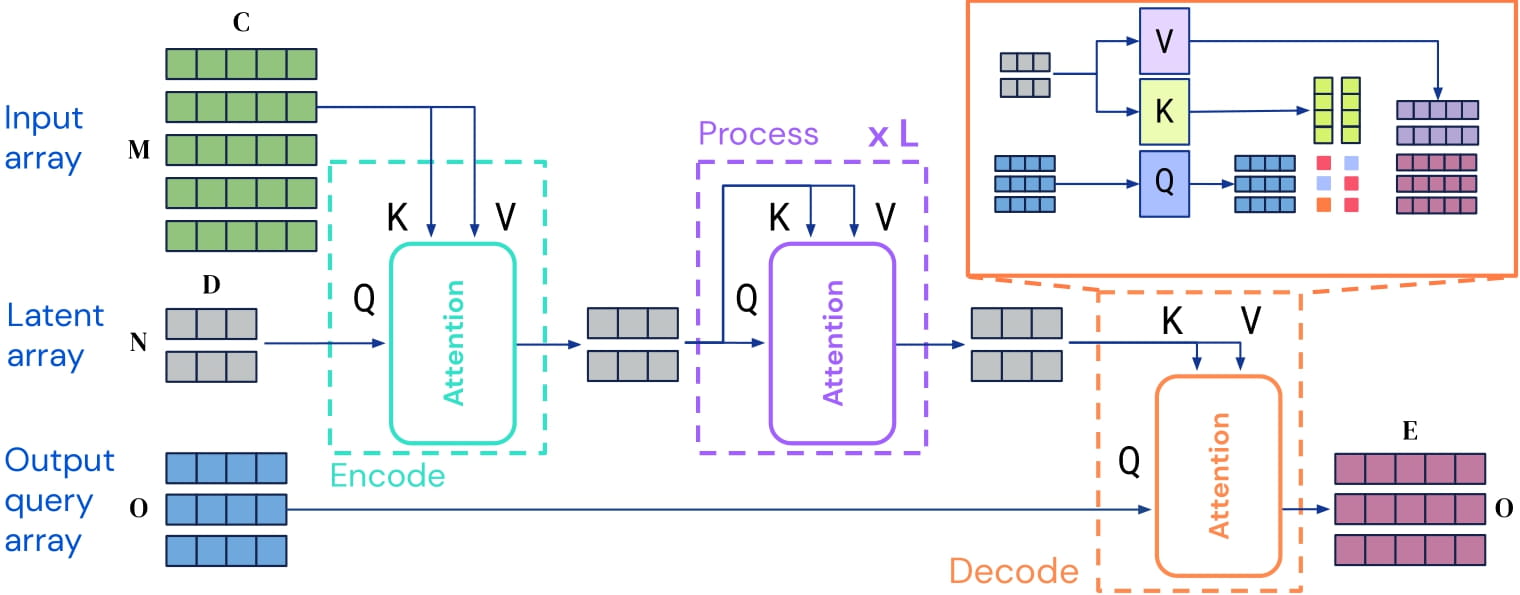 بنية Perceiver IO. مأخوذة من الورقة الأصلية
تمت مساهمة هذا النموذج من قِبل [nielsr](https://huggingface.co/nielsr). يمكن العثور على الكود الأصلي [هنا](https://github.com/deepmind/deepmind-research/tree/master/perceiver).
لا يعمل Perceiver **إلا** مع `torch.nn.DataParallel` بسبب خطأ برمجي في PyTorch، راجع [المشكلة #36035](https://github.com/pytorch/pytorch/issues/36035)
## الموارد
- أسرع طريقة للبدء مع Perceiver هي الاطلاع على [دفاتر التعليم](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Perceiver).
- راجع [المنشور على المدونة](https://huggingface.co/blog/perceiver) إذا كنت ترغب في فهم كيفية عمل النموذج بشكل كامل و
يتم تنفيذه في المكتبة. لاحظ أن النماذج المتاحة في المكتبة تعرض بعض الأمثلة فقط لما يمكنك القيام به باستخدام Perceiver. هناك العديد من حالات الاستخدام الأخرى، بما في ذلك الإجابة على الأسئلة، والتعرف على الكيانات المسمّاة، واكتشاف الأشياء، وتصنيف الصوت، وتصنيف الفيديو، وغيرها.
- [دليل مهمة تصنيف النصوص](../tasks/sequence_classification)
- [دليل مهمة نمذجة اللغة المقنّعة](../tasks/masked_language_modeling)
- [دليل مهمة تصنيف الصور](../tasks/image_classification)
## المخرجات الخاصة بـ Perceiver[[transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput(logits: typing.Optional[torch.Tensor] = None, last_hidden_state: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor] | None = None, attentions: tuple[torch.Tensor] | None = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L53)
**المعاملات:**
logits (`torch.Tensor` من الشكل `(batch_size, num_labels)`) : درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).
last_hidden_state (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : تسلسل من حالات الإخفاء عند مخرج الطبقة الأخيرة من النموذج.
hidden_states (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) : مجموعة من `torch.Tensor` (واحد لإخراج الطبقات المضمنة إذا كان النموذج يحتوي على طبقة تضمين، + واحد لإخراج كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`. حالات مخفية للنموذج عند إخراج كل طبقة بالإضافة إلى مخرجات التضمين الأولية الاختيارية.
attentions (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) : مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`. أوزان الانتباه بعد تطبيق softmax على الانتباه، وتُستخدم لحساب المتوسط المرجح في رؤوس الانتباه الذاتي.
cross_attentions (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) : مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`. أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط المرجح في رؤوس الانتباه المتقاطع.
الفئة الأساسية لمخرجات نموذج Perceiver الأساسي، مع حالات خفية محتملة، وانتباه، وانتباه متقاطع.
#### transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput(logits: typing.Optional[torch.Tensor] = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L72)
**المعاملات:**
logits (`torch.Tensor` من الشكل `(batch_size, num_labels)`) : مخرج المُفكِّك الأساسي.
cross_attentions (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) : مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`. أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط المرجح في رؤوس الانتباه المتقاطع.
الفئة الأساسية لمخرجات فاحص Perceiver، مع احتمالية وجود انتباه متقاطع.
#### transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput(loss: typing.Optional[torch.Tensor] = None, logits: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor] | None = None, attentions: tuple[torch.Tensor] | None = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L88)
**المعاملات:**
loss (`torch.Tensor` من الشكل `(1,)`، *اختياري*، يُعاد عند توفير `labels`) : خسارة نمذجة اللغة المقنّعة (MLM).
logits (`torch.Tensor` من الشكل `(batch_size, sequence_length, config.vocab_size)`) : درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).
hidden_states (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) : مجموعة من `torch.Tensor` (واحد لإخراج الطبقات المضمنة إذا كان النموذج يحتوي على طبقة تضمين، + واحد لإخراج كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`. حالات مخفية للنموذج عند إخراج كل طبقة بالإضافة إلى مخرجات التضمين الأولية الاختيارية.
attentions (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) : مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`. أوزان الانتباه بعد تطبيق softmax على الانتباه، وتُستخدم لحساب المتوسط المرجح في رؤوس الانتباه الذاتي.
cross_attentions (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) : مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`. أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط المرجح في رؤوس الانتباه المتقاطع.
الفئة الأساسية لمخرجات نموذج اللغة المقنّع الخاص بـ Perceiver.
#### transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput(loss: typing.Optional[torch.Tensor] = None, logits: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor] | None = None, attentions: tuple[torch.Tensor] | None = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L110)
**المعاملات:**
loss (`torch.Tensor` من الشكل `(1,)`، *اختياري*، يُعاد عند توفير `labels`) : خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).
logits (`torch.Tensor` من الشكل `(batch_size, config.num_labels)`) : درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).
hidden_states (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) : مجموعة من `torch.Tensor` (واحد لإخراج الطبقات المضمنة إذا كان النموذج يحتوي على طبقة تضمين، + واحد لإخراج كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`. حالات مخفية للنموذج عند إخراج كل طبقة بالإضافة إلى مخرجات التضمين الأولية الاختيارية.
attentions (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) : مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`. أوزان الانتباه بعد تطبيق softmax على الانتباه، وتُستخدم لحساب المتوسط المرجح في رؤوس الانتباه الذاتي.
cross_attentions (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) : مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`. أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط المرجح في رؤوس الانتباه المتقاطع.
الفئة الأساسية لمخرجات Perceiver لنماذج تصنيف التسلسل/الصورة، وتدفق الضوء، والترميز الذاتي متعدد الوسائط.
## PerceiverConfig[[transformers.PerceiverConfig]]
#### transformers.PerceiverConfig[[transformers.PerceiverConfig]]
```python
transformers.PerceiverConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, num_latents: int = 256, d_latents: int = 1280, d_model: int = 768, num_blocks: int = 1, num_self_attends_per_block: int = 26, num_self_attention_heads: int = 8, num_cross_attention_heads: int = 8, qk_channels: int | None = None, v_channels: int | None = None, cross_attention_shape_for_attention: str = 'kv', self_attention_widening_factor: int = 1, cross_attention_widening_factor: int = 1, hidden_act: str = 'gelu', attention_probs_dropout_prob: float | int = 0.1, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, use_query_residual: bool = True, vocab_size: int = 262, max_position_embeddings: int = 2048, image_size: int | list[int] | tuple[int, int] = 56, train_size: list[int] | tuple[int, ...] = (368, 496), num_frames: int = 16, audio_samples_per_frame: int = 1920, samples_per_patch: int = 16, output_shape: list[int] | tuple[int, ...] = (1, 16, 224, 224), output_num_channels: int = 512, _label_trainable_num_channels: int = 1024)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/configuration_perceiver.py#L24)
**المعاملات:**
num_latents (`int`، *اختياري*، القيمة الافتراضية 256) : عدد الكمونيات (latents).
d_latents (`int`، *اختياري*، القيمة الافتراضية 1280) : بُعد التضمينات الكامنة.
d_model (`int`، *اختياري*، القيمة الافتراضية `768`) : حجم طبقات المُشفِّر وطبقة المُجمِّع.
num_blocks (`int`، *اختياري*، القيمة الافتراضية 1) : عدد الكتل في مُشفِّر Transformer.
num_self_attends_per_block (`int`، *اختياري*، القيمة الافتراضية 26) : عدد طبقات الانتباه الذاتي في كل كتلة.
num_self_attention_heads (`int`، *اختياري*، القيمة الافتراضية 8) : عدد رؤوس الانتباه لكل طبقة ذاتية الانتباه في مُشفِّر Transformer.
num_cross_attention_heads (`int`، *اختياري*، القيمة الافتراضية 8) : عدد رؤوس الانتباه لكل طبقة انتباه متقاطع في مُشفِّر Transformer.
qk_channels (`int`, *اختياري*) : البُعد الذي تُسقط عليه الاستعلامات + المفاتيح قبل تطبيق الانتباه في طبقات الانتباه المتقاطع والانتباه الذاتي داخل المُشفِّر. إذا لم يُحدد، فسيتم افتراضياً الحفاظ على بُعد الاستعلامات.
v_channels (`int`, *اختياري*) : البُعد الذي تُسقط إليه القيم قبل تطبيق الانتباه في طبقات الانتباه المتقاطع والانتباه الذاتي داخل المُشفِّر. إذا لم يُحدَّد، فسيتم افتراضيًا الحفاظ على بُعد الاستعلامات.
cross_attention_shape_for_attention (`str`، *اختياري*، القيمة الافتراضية `"kv"`) : البُعد الذي يُستخدم عند تقليل حجم الاستعلامات والمفاتيح في طبقة الانتباه المتقاطع في المُشفِّر.
self_attention_widening_factor (`int`، *اختياري*، القيمة الافتراضية 1) : بُعد طبقة التغذية الأمامية في طبقة الانتباه المتقاطع في مُشفِّر Transformer.
cross_attention_widening_factor (`int`، *اختياري*، القيمة الافتراضية 1) : بُعد طبقة التغذية الأمامية في طبقات الانتباه الذاتي في مُشفِّر Transformer.
hidden_act (`str`، *اختياري*، القيمة الافتراضية `gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
attention_probs_dropout_prob (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.1`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
layer_norm_eps (`float`، *اختياري*، القيمة الافتراضية `1e-12`) : قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
use_query_residual (`float`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إضافة بقية الاستعلام في طبقة الانتباه المتقاطع في المُشفِّر.
vocab_size (`int`، *اختياري*، القيمة الافتراضية `262`) : حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطة `input_ids`.
max_position_embeddings (`int`، *اختياري*، القيمة الافتراضية `2048`) : الحد الأقصى لطول التسلسل الذي قد يُستخدم به هذا النموذج.
image_size (`int`، *اختياري*، القيمة الافتراضية 56) : حجم الصور بعد المعالجة المسبقة، لـ [PerceiverForImageClassificationLearned](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned).
train_size (`list[int]`، *اختياري*، القيمة الافتراضية `[368, 496]`) : حجم الصور أثناء التدريب لنموذج التدفق البصري.
num_frames (`int`، *اختياري*، القيمة الافتراضية 16) : عدد إطارات الفيديو المستخدمة في نموذج الترميز التلقائي متعدد الوسائط.
audio_samples_per_frame (`int`، *اختياري*، القيمة الافتراضية 1920) : عدد عينات الصوت لكل إطار في نموذج الترميز التلقائي متعدد الوسائط.
samples_per_patch (`int`، *اختياري*، القيمة الافتراضية 16) : عدد عينات الصوت لكل رقعة عند المعالجة المسبقة للصوت لنموذج الترميز التلقائي متعدد الوسائط.
output_shape (`list[int]`، *اختياري*، القيمة الافتراضية `[1, 16, 224, 224]`) : شكل المخرجات (batch_size, num_frames, height, width) لاستعلامات مُفكِّك الفيديو في نموذج الترميز التلقائي متعدد الوسائط. يستثني هذا بُعد القناة.
output_num_channels (`int`، *اختياري*، القيمة الافتراضية 512) : عدد قنوات الإخراج لكل مُفكِّك نمط.
هذه فئة الإعدادات المخزنة لإعدادات PerceiverModel. تُستخدم لاستحداث نموذج Perceiver وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [deepmind/language-perceiver](https://huggingface.co/deepmind/language-perceiver)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import PerceiverModel, PerceiverConfig
>>> # Initializing a Perceiver deepmind/language-perceiver style configuration
>>> configuration = PerceiverConfig()
>>> # Initializing a model from the deepmind/language-perceiver style configuration
>>> model = PerceiverModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## PerceiverTokenizer[[transformers.PerceiverTokenizer]]
#### transformers.PerceiverTokenizer[[transformers.PerceiverTokenizer]]
```python
transformers.PerceiverTokenizer(pad_token = '[PAD]', bos_token = '[BOS]', eos_token = '[EOS]', mask_token = '[MASK]', cls_token = '[CLS]', sep_token = '[SEP]', model_max_length = 2048, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/tokenization_perceiver.py#L23)
**المعاملات:**
pad_token (`str`، *اختياري*، الافتراضي هو `"[PAD]"`) : الرمز المستخدم للتعبئة، على سبيل المثال عند تجميع تسلسلات ذات أطوال مختلفة.
bos_token (`str`، *اختياري*، القيمة الافتراضية `"[BOS]"`) : رمز بداية الجملة (محجوز في قاموس الرموز، لكنه غير مستخدم فعليًا).
eos_token (`str`، *اختياري*، القيمة الافتراضية `"[EOS]"`) : رمز نهاية التسلسل (محجوز في قاموس الرموز، لكنه غير مستخدم فعليًا). عند بناء تسلسل باستخدام الرموز الخاصة، فإن هذا ليس الرمز المستخدم لنهاية التسلسل. الرمز المستخدم هو `sep_token`.
mask_token (`str`، *اختياري*، القيمة الافتراضية `"[MASK]"`) : رمز MASK، مفيد لنمذجة اللغة المقنّعة.
cls_token (`str`، *اختياري*، القيمة الافتراضية `"[CLS]"`) : رمز CLS (محجوز في قاموس الكلمات، لكنه غير مستخدم فعليًا).
sep_token (`str`، *اختياري*، القيمة الافتراضية `"[SEP]"`) : رمز الفاصل، الذي يُستخدم عند بناء تسلسل من تسلسلين.
أنشئ مُرمِّز Perceiver. يستخدم Perceiver ببساطة ترميز البايتات الخام utf-8.
يرث هذا المُجزِّئ من [PreTrainedTokenizer](/docs/transformers/v5.23.0/ar/main_classes/tokenizer#transformers.PythonBackend) التي تحتوي على معظم الطرق الرئيسية. ينبغي للمستخدمين الرجوع إلى هذه الفئة الأصلية لمزيد من المعلومات حول تلك الطرق.
#### __call__[[transformers.PerceiverTokenizer.__call__]]
```python
__call__(text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, text_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, text_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, text_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, add_special_tokens: bool = True, padding: bool | str | PaddingStrategy = False, truncation: bool | str | TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, is_split_into_words: bool = False, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, tokenizer_kwargs: dict[str, Any] | None = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/tokenization_utils_base.py#L2448)
**المعاملات:**
text (`str`، `list[str]`، `list[list[str]]`، *اختياري*) : التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُجزَّأ مسبقًا). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مُجزَّأة مسبقًا)، فيجب تعيين `is_split_into_words=True` (لرفع الغموض مع دفعة من التسلسلات).
text_pair (`str`، `list[str]`، `list[list[str]]`، *اختياري*) : التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُجزَّأ مسبقًا). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مُجزَّأة مسبقًا)، فيجب تعيين `is_split_into_words=True` (لرفع الغموض مع دفعة من التسلسلات).
text_target (`str`، `list[str]`، `list[list[str]]`، *اختياري*) : التسلسل أو الدفعة من التسلسلات المراد ترميزها كنصوص هدف. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُقسَّم مسبقًا إلى وحدات). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مقسمة مسبقًا)، فيجب تعيين `is_split_into_words=True` (لرفع الغموض مع دفعة من التسلسلات).
text_pair_target (`str`، `list[str]`، `list[list[str]]`، *اختياري*) : التسلسل أو الدفعة من التسلسلات المراد ترميزها كنصوص هدف. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُقسَّم مسبقًا إلى وحدات). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مقسمة مسبقًا)، فيجب تعيين `is_split_into_words=True` (لرفع الغموض مع دفعة من التسلسلات).
tokenizer_kwargs (`dict[str, Any]`، *اختياري*) : معاملات إضافية (kwargs) تُمرَّر إلى مُجزِّئ الرموز (tokenizer). سيتم دمج هذه المعاملات مع المعاملات الصريحة وغيرها من المعاملات الإضافية، مع إعطاء الأولوية للمعاملات الصريحة.
add_special_tokens (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إضافة الرموز الخاصة عند ترميز التسلسلات أم لا. سيستخدم هذا الدالة الأساسية `PretrainedTokenizerBase.build_inputs_with_special_tokens`، التي تحدد الرموز التي تُضاف تلقائيًا إلى معرّفات الإدخال. وهذا مفيد إذا كنت ترغب في إضافة رموز `bos` أو `eos` تلقائيًا.
padding (`bool` أو `str` أو [PaddingStrategy](/docs/transformers/v5.23.0/ar/internal/file_utils#transformers.utils.PaddingStrategy)، *اختياري*، القيمة الافتراضية هي `False`) : يُفعّل التحكم في الحشو. يقبل القيم التالية: - `True` أو `'longest'`: حشو حتى أطول تسلسل في الدفعة (أو بدون حشو إذا تم تقديم تسلسل واحد فقط). - `'max_length'`: حشو حتى الحد الأقصى للطول المحدد بواسطة الحجة `max_length` أو حتى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. - `False` أو `'do_not_pad'` (الافتراضي): بدون حشو (أي، يمكنه إخراج دفعة تحتوي على تسلسلات بطول مختلف).
truncation (`bool` أو `str` أو [TruncationStrategy](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy)، *اختياري*، القيمة الافتراضية `False`) : يُفعّل التحكم في القص. يقبل القيم التالية: - `True` أو `'longest_first'`: يُقصّ إلى الحد الأقصى للطول المحدد عبر الحجة `max_length` أو إلى الحد الأقصى لطول الإدخال المقبول للنموذج إذا لم تُقدَّم تلك الحجة. سيؤدي هذا إلى القص رمزًا تلو الآخر، مع إزالة رمز من أطول تسلسل في الزوج إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج). - `'only_first'`: يُقصّ إلى الحد الأقصى للطول المحدد عبر الحجة `max_length` أو إلى الحد الأقصى لطول الإدخال المقبول للنموذج إذا لم تُقدَّم تلك الحجة. سيؤدي هذا إلى قصّ التسلسل الأول من الزوج فقط إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج). - `'only_second'`: يُقصّ إلى الحد الأقصى للطول المحدد عبر الحجة `max_length` أو إلى الحد الأقصى لطول الإدخال المقبول للنموذج إذا لم تُقدَّم تلك الحجة. سيؤدي هذا إلى قصّ التسلسل الثاني من الزوج فقط إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج). - `False` أو `'do_not_truncate'` (الافتراضي): لا يوجد قص (أي، يمكن إخراج دفعة بأطوال تسلسلات أكبر من الحد الأقصى المقبول لحجم الإدخال للنموذج).
max_length (`int`, *اختياري*) : يتحكم في الحد الأقصى للطول الذي سيستخدمه أحد معاملات القص/الحشو. إذا تُرك غير مضبوط أو ضُبط على `None`، فسيتم استخدام الحد الأقصى للطول المحدد مسبقًا للنموذج إذا كان أحد معاملات القص/الحشو يتطلب حدًا أقصى للطول. إذا لم يكن للنموذج حد أقصى محدد لطول الإدخال (مثل XLNet)، فسيتم تعطيل القص/الحشو إلى حد أقصى للطول.
stride (`int`، *اختياري*، القيمة الافتراضية 0) : إذا تم تعيينه إلى رقم مع `max_length`، فإن الرموز الزائدة المُعاد عند `return_overflowing_tokens=True` ستحتوي على بعض الرموز من نهاية التسلسل المُقتطع المُعاد، لتوفير بعض التداخل بين التسلسلات المُقتطعة والتسلسلات الزائدة. تحدد قيمة هذا الحجة عدد الرموز المتداخلة.
is_split_into_words (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كانت المدخلات مُجزّأة مسبقًا (مثل تقسيمها إلى كلمات) أم لا. إذا تم ضبطها على `True`، يفترض المُجزّئ أن المدخلات مُقسّمة مسبقًا إلى كلمات (على سبيل المثال، عن طريق تقسيمها على المسافات) وسيُجزّئها. هذا مفيد في مهام تحديد الكيانات الاسمية أو تصنيف الرموز.
pad_to_multiple_of (`int`, *اختياري*) : إذا تم ضبطه، سيتم توسيط التسلسل إلى مضاعف للقيمة المُقدَّمة. يتطلب تفعيل `padding`. وهذا مفيد بشكل خاص لتمكين استخدام نوى التENSOR على أجهزة NVIDIA التي تتمتع بقابلية حسابية `>= 7.5` (Volta).
padding_side (`str`، *اختياري*) : الجانب الذي يجب تطبيق الحشو عليه في النموذج. يجب اختياره من بين ['right', 'left']. القيمة الافتراضية تُستخرج من سمة الفئة التي تحمل الاسم نفسه.
return_tensors (`str` أو [TensorType](/docs/transformers/v5.23.0/ar/internal/file_utils#transformers.TensorType)، *اختياري*) : إذا تم تعيينه، فسيُرجع تينسورات بدلاً من قائمة من الأعداد الصحيحة بلغة بايثون. القيم المقبولة هي: - `'pt'`: يُرجع كائنات `torch.Tensor` من PyTorch. - `'np'`: يُرجع كائنات `np.ndarray` من Numpy.
return_token_type_ids (`bool`، *اختياري*) : ما إذا كان يجب إرجاع معرّفات أنواع الرموز. إذا تُركت القيمة الافتراضية، فسيتم إرجاع معرّفات أنواع الرموز وفقًا للقيمة الافتراضية الخاصة بمجزّئ الرموز المحدد، كما تحددها خاصية `return_outputs`. [ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
return_attention_mask (`bool`، *اختياري*) : ما إذا كان يجب إرجاع قناع الانتباه. إذا تُركت القيمة الافتراضية، فسيتم إرجاع قناع الانتباه وفقاً للقيمة الافتراضية الخاصة بمجزّئ الرموز المعني، كما هو معرّف بواسطة الخاصية `return_outputs`. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
return_overflowing_tokens (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم إرجاع تسلسلات الرموز المتجاوزة أم لا. إذا تم تقديم زوج من تسلسلات معرّفات الإدخال (أو دفعة من الأزواج) مع `truncation_strategy = longest_first` أو `True`، فسيتم رفع خطأ بدلاً من إرجاع الرموز المتجاوزة.
return_special_tokens_mask (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم إرجاع معلومات قناع الرموز الخاصة أم لا.
return_offsets_mapping (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان يجب إرجاع `(char_start, char_end)` لكل رمز. هذه الخاصية متاحة فقط في مُرمّزيات fast التي ترث من [PreTrainedTokenizerFast](/docs/transformers/v5.23.0/ar/main_classes/tokenizer#transformers.TokenizersBackend)، وإذا كنت تستخدم مُرمّزي Python، فسيُطلق هذا الدالة `NotImplementedError`.
return_length (`bool`، *اختياري*، الافتراضي `False`) : ما إذا كان يجب إرجاع أطوال المدخلات المُرمّزة أم لا.
verbose (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب طباعة مزيد من المعلومات والتنبيهات أم لا.
- ****kwargs** : تُمرَّر إلى طريقة `self.tokenize()`
**يعيد:** [BatchEncoding](/docs/transformers/v5.23.0/ar/main_classes/tokenizer#transformers.BatchEncoding)
[BatchEncoding](/docs/transformers/v5.23.0/ar/main_classes/tokenizer#transformers.BatchEncoding) يحتوي على الحقول التالية:
- **input_ids** -- قائمة معرّفات الرموز المراد تغذيتها إلى النموذج.
[ما هي معرّفات الإدخال؟](../glossary#input-ids)
- **token_type_ids** -- قائمة معرّفات أنواع الرموز التي تُمرَّر إلى النموذج (عندما يكون `return_token_type_ids=True` أو إذا كان *"token_type_ids"* ضمن `self.model_input_names`).
[ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
- **attention_mask** -- قائمة بالفهارس تحدد الرموز التي يجب على النموذج الانتباه إليها (عندما يكون `return_attention_mask=True` أو إذا كان *"attention_mask"* ضمن `self.model_input_names`).
[ما هي أقنعة الانتباه؟](../glossary#attention-mask)
- **overflowing_tokens** -- قائمة تسلسلات الرموز الزائدة (عند تحديد `max_length` و`return_overflowing_tokens=True`).
- **num_truncated_tokens** -- عدد الرموز التي تم اقتطاعها (عند تحديد `max_length` و`return_overflowing_tokens=True`).
- **special_tokens_mask** -- قائمة من الأصفار والواحدات، حيث تشير 1 إلى الرموز الخاصة المضافة وتُشير 0 إلى رموز التسلسل العادية (عندما تكون `add_special_tokens=True` و`return_special_tokens_mask=True`).
- **length** -- طول المدخلات (عندما يكون `return_length=True`)
الطريقة الرئيسية لتجزئة (tokenization) وتجهيز تسلسل واحد أو عدة تسلسلات، أو زوج واحد أو عدة أزواج من التسلسلات، للنموذج.
## PerceiverImageProcessor[[transformers.PerceiverImageProcessor]]
#### transformers.PerceiverImageProcessor[[transformers.PerceiverImageProcessor]]
```python
transformers.PerceiverImageProcessor(**kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/image_processing_perceiver.py#L33)
**المعاملات:**
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*، الافتراضي هو `True`) : ما إذا كان سيتم تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية هي `{'height' : 224, 'width': 224}`): يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم من نوع عدد صحيح.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية `{'height' : 256, 'width': 256}`): حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`، *kwargs*، القيمة الافتراضية `3`) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كانت قيمة `do_resize` هي `True`.
do_rescale (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*، القيمة الافتراضية هي `0.00392156862745098`) : عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطاً على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية `[0.485, 0.456, 0.406]`) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية `[0.229, 0.224, 0.225]`) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *اختياري*, القيمة الافتراضية هي `True`) : ما إذا كان سيتم قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
ينشئ معالج صور PerceiverImageProcessor.
#### preprocess[[transformers.PerceiverImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : الصورة المراد معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`، *اختياري*) : علم مخصص للمطورين لإدخال مدخلات إضافية تشبه الصور والتي سيتم معالجتها مسبقًا أيضًا. استخدم هذا الخيار فقط إذا لم يعمل تمرير المدخلات كحجة اسمية (kwarg). على سبيل المثال، يُعد `preprocess(images, masks=masks)` الخيار المفضل، لكنه يؤدي إلى مشاكل في أولوية الحجة لبعض النماذج. في تلك الحالات، يمكن استخدام `preprocess(images, image_like_inputs={"masks": masks})` بدلاً منه.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم عددًا صحيحًا.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*) : معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطًا على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
معالجة صورة أو دفعة من الصور مسبقًا.
## PerceiverImageProcessorPil[[transformers.PerceiverImageProcessorPil]]
#### transformers.PerceiverImageProcessorPil[[transformers.PerceiverImageProcessorPil]]
```python
transformers.PerceiverImageProcessorPil(**kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/image_processing_pil_perceiver.py#L31)
**المعاملات:**
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*، الافتراضي هو `True`) : ما إذا كان سيتم تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية هي `{'height' : 224, 'width': 224}`): يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم من نوع عدد صحيح.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية `{'height' : 256, 'width': 256}`): حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`، *kwargs*، القيمة الافتراضية `3`) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كانت قيمة `do_resize` هي `True`.
do_rescale (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*، القيمة الافتراضية هي `0.00392156862745098`) : عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطاً على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية `[0.485, 0.456, 0.406]`) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية `[0.229, 0.224, 0.225]`) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *اختياري*, القيمة الافتراضية هي `True`) : ما إذا كان سيتم قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
ينشئ معالج صور PerceiverImageProcessor.
#### preprocess[[transformers.PerceiverImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : الصورة المراد معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`، *اختياري*) : علم مخصص للمطورين لإدخال مدخلات إضافية تشبه الصور والتي سيتم معالجتها مسبقًا أيضًا. استخدم هذا الخيار فقط إذا لم يعمل تمرير المدخلات كحجة اسمية (kwarg). على سبيل المثال، يُعد `preprocess(images, masks=masks)` الخيار المفضل، لكنه يؤدي إلى مشاكل في أولوية الحجة لبعض النماذج. في تلك الحالات، يمكن استخدام `preprocess(images, image_like_inputs={"masks": masks})` بدلاً منه.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم عددًا صحيحًا.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*) : معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطًا على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
معالجة صورة أو دفعة من الصور مسبقًا.
## PerceiverTextPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor(config: PerceiverConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2662)
**المعاملات:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) : إعدادات النموذج.
معالجة النصوص المسبقة لمُشفِّر Perceiver. يمكن استخدامه لتضمين `inputs` وإضافة الترميزات الموضعية.
تُحدَّد أبعاد التضمينات من خلال خاصية `d_model` في الإعداد.
## PerceiverImagePreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor(config, prep_type = 'conv', spatial_downsample: int = 4, temporal_downsample: int = 1, position_encoding_type: str = 'fourier', in_channels: int = 3, out_channels: int = 64, conv_after_patching: bool = False, conv_after_patching_in_channels: int = 54, conv2d_use_batchnorm: bool = True, concat_or_add_pos: str = 'concat', project_pos_dim: int = -1, **position_encoding_kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2825)
**المعاملات:**
config ([*PerceiverConfig*]) : إعدادات النموذج.
prep_type (`str`، *اختياري*، الافتراضي `"conv"`) : نوع المعالجة المسبقة. يمكن أن يكون "conv1x1" أو "conv" أو "patches" أو "pixels".
spatial_downsample (`int`، *اختياري*، القيمة الافتراضية 4) : عامل تصغير مكاني.
temporal_downsample (`int`، *اختياري*، القيمة الافتراضية 1) : معامل تقليل العينات الزمنية (لا ينطبق إلا في حال وجود بُعد زمني).
position_encoding_type (`str`، *اختياري*، القيمة الافتراضية `"fourier"`) : نوع ترميز الموقع. يمكن أن يكون "fourier" أو "trainable".
in_channels (`int`، *اختياري*، القيمة الافتراضية 3) : عدد القنوات في المدخلات.
out_channels (`int`، *اختياري*، القيمة الافتراضية 64) : عدد القنوات في المخرجات.
conv_after_patching (`bool`، *اختياري*، الافتراضي `False`) : ما إذا كان سيتم تطبيق طبقة تلافيفية بعد التقطيع.
conv_after_patching_in_channels (`int`، *اختياري*، القيمة الافتراضية 54) : عدد القنوات في مدخل طبقة الالتفاف بعد التقطيع.
conv2d_use_batchnorm (`bool`، *اختياري*، الافتراضي `True`) : ما إذا كان سيتم استخدام تطبيع الدفعة في الطبقة الالتفافية.
concat_or_add_pos (`str`، *اختياري*، القيمة الافتراضية `"concat"`) : كيفية دمج ترميز الموقع مع المدخلات. يمكن أن تكون "concat" أو "add".
project_pos_dim (`int`، *اختياري*، القيمة الافتراضية -1) : بُعد ترميز الموضع الذي سيتم الإسقاط إليه. إذا كانت القيمة -1، فلا يُطبق أي إسقاط.
- ****position_encoding_kwargs** (`Dict`، *اختياري*) : معاملات الكلمات المفتاحية لتشفير المواقع.
معالجة الصور المسبقة لمُشفِّر Perceiver.
ملاحظة: يشير الحُجج *out_channels* إلى قنوات المخرجات لطبقة الالتفاف، إذا كان *prep_type* مضبوطاً على "conv1x1" أو "conv". إذا أضفنا تضمينات الموضع المطلق، يجب التأكد من ضبط *num_channels* في معاملات الترميز الموضعي (kwargs) مساوياً لـ *out_channels*.
## PerceiverOneHotPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor(config: PerceiverConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L3063)
**المعاملات:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) : إعدادات النموذج.
معالج مسبق بنمط One-hot لمُشفِّر Perceiver. يمكن استخدامه لإبعاد مؤشر وهمي إلى المدخلات.
## PerceiverAudioPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor(config, prep_type: str = 'patches', samples_per_patch: int = 96, position_encoding_type: str = 'fourier', concat_or_add_pos: str = 'concat', out_channels = 64, project_pos_dim = -1, **position_encoding_kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L3089)
**المعاملات:**
config ([*PerceiverConfig*]) : إعدادات النموذج.
prep_type (`str`، *اختياري*، الافتراضي `"patches"`) : نوع المعالج المسبق للاستخدام. يتم دعم "patches" فقط.
samples_per_patch (`int`، *اختياري*، القيمة الافتراضية 96) : عدد العينات لكل رقعة.
position_encoding_type (`str`، *اختياري*، الافتراضي `"fourier"`) : نوع ترميز الموقع المستخدم. يمكن أن يكون "trainable" أو "fourier".
concat_or_add_pos (`str`، *اختياري*، القيمة الافتراضية `"concat"`) : كيفية دمج ترميز الموقع مع المدخلات. يمكن أن تكون "concat" أو "add".
out_channels (`int`، *اختياري*، القيمة الافتراضية 64) : عدد القنوات في المخرجات.
project_pos_dim (`int`، *اختياري*، القيمة الافتراضية -1) : بُعد ترميز الموضع الذي سيتم الإسقاط إليه. إذا كانت القيمة -1، فلا يُطبق أي إسقاط.
- ****position_encoding_kwargs** (`Dict`، *اختياري*) : معاملات الكلمات المفتاحية لتشفير المواقع.
معالجة مسبقة للصوت لمُشفِّر Perceiver.
## PerceiverMultimodalPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor(modalities: collections.abc.Mapping[str, collections.abc.Callable[..., tuple[torch.Tensor, typing.Optional[torch.Tensor], torch.Tensor]]], mask_probs: collections.abc.Mapping[str, float] | None = None, min_padding_size: int = 2)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L3192)
**المعاملات:**
modalities (`Mapping[str, PreprocessorType]`) : قاموس يربط اسم النمط (modality) بمعالج ما قبل المعالجة (preprocessor).
mask_probs (`dict[str, float]`) : قاموس يربط اسم النمط (modality) باحتمالية إخفاء ذلك النمط.
min_padding_size (`int`، *اختياري*، القيمة الافتراضية 2) : الحد الأدنى لحجم الحشو لجميع الأنماط. سيكون عدد القنوات في المخرجات النهائية مساويًا لأكبر عدد قنوات عبر جميع الأنماط مضافًا إليه min_padding_size.
المعالجة المسبقة متعددة الوسائط لمشفّر Perceiver.
تتم معالجة المدخلات الخاصة بكل نمط مسبقًا، ثم تُملأ بتضمينات مواقع قابلة للتدريب بحيث تمتلك جميعها نفس عدد القنوات.
## PerceiverProjectionDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder(config)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1839)
**المعاملات:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) : إعدادات النموذج.
مفكك التنبؤ الأساسي (بدون الانتباه المتقاطع).
## PerceiverBasicDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder(config: PerceiverConfig, output_num_channels: int, position_encoding_type: str | None = 'trainable', output_index_dims: int | None = None, num_channels: int | None = 128, subsampled_index_dims: int | None = None, qk_channels: int | None = None, v_channels: int | None = None, num_heads: int | None = 1, widening_factor: int | None = 1, use_query_residual: bool | None = False, concat_preprocessed_input: bool | None = False, final_project: bool | None = True, position_encoding_only: bool | None = False, **position_encoding_kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1863)
**المعاملات:**
config ([*PerceiverConfig*]) : إعدادات النموذج.
output_num_channels (`int`, *اختياري*) : عدد القنوات في المخرجات. لن يُستخدم إلا إذا تم تعيين *final_project* إلى `True`.
position_encoding_type (`str`، *اختياري*، القيمة الافتراضية "trainable") : نوع ترميز الموضع الذي سيتم استخدامه. يمكن أن يكون "trainable" أو "fourier" أو "none".
output_index_dims (`int`, *اختياري*) : عدد أبعاد الاستعلامات الناتجة. يتم تجاهله إذا كان 'position_encoding_type' == 'none'.
num_channels (`int`، *اختياري*، القيمة الافتراضية 128) : عدد قنوات استعلامات المُفكِّك. يتم تجاهله إذا كان 'position_encoding_type' == 'none'.
qk_channels (`int`، *اختياري*) : عدد قنوات الاستعلامات والمفاتيح في طبقة الانتباه المتقاطع.
v_channels (`int`, *اختياري*) : عدد قنوات القيم في طبقة الانتباه المتقاطع.
num_heads (`int`، *اختياري*، القيمة الافتراضية 1) : عدد رؤوس الانتباه في طبقة الانتباه المتقاطع.
widening_factor (`int`، *اختياري*، القيمة الافتراضية 1) : معامل توسيع طبقة الانتباه المتقاطع.
use_query_residual (`bool`، *اختياري*، الافتراضي `False`) : ما إذا كان سيتم استخدام اتصال متبقٍ بين الاستعلام ومخرجات طبقة الانتباه المتقاطع.
concat_preprocessed_input (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان يجب دمج المدخلات المُعالجة مسبقًا مع الاستعلام.
final_project (`bool`، *اختياري*، الافتراضي `True`) : ما إذا كان سيتم إسقاط مخرجات طبقة الانتباه المتقاطع إلى بُعد مستهدف.
position_encoding_only (`bool`، *اختياري*، الافتراضي `False`) : ما إذا كان يجب استخدام هذه الفئة فقط لتعريف استعلامات الإخراج.
مفكك يعتمد على الانتباه المتقاطع. يمكن استخدام هذه الفئة لفك ترميز الحالات المخفية النهائية للكائنات الكامنة باستخدام عملية انتباه متقاطع، حيث تنتج الكائنات الكامنة المفاتيح والقيم.
يعتمد شكل المخرجات لهذه الفئة على كيفية تعريف استعلامات المخرجات (المعروفة أيضاً باستعلامات المُفكِّك).
## PerceiverClassificationDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder(config, **decoder_kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2048)
**المعاملات:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) : إعدادات النموذج.
مفكك تصنيف يعتمد على الانتباه المتقاطع. غلاف خفيف الوزن لـ`PerceiverBasicDecoder` لإخراج القيم اللوغاريتمية. سيحوّل مخرج مشفر Perceiver الذي يكون شكله (batch_size, num_latents, d_latents) إلى متجه من الشكل (batch_size, num_labels). تكون الاستعلامات من الشكل (batch_size, 1, num_labels).
## PerceiverOpticalFlowDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder(config, output_image_shape, output_num_channels = 2, rescale_factor = 100.0, **decoder_kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2094)
مفكك تدفق بصري يعتمد على الانتباه المتقاطع.
## PerceiverBasicVideoAutoencodingDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder(config: PerceiverConfig, output_shape: list[int], position_encoding_type: str, **decoder_kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2129)
**المعاملات:**
config ([*PerceiverConfig*]) : إعدادات النموذج.
output_shape (`list[int]`) : شكل المخرجات على النحو (batch_size, num_frames, height, width)، مع استبعاد بُعد القناة.
position_encoding_type (`str`) : نوع ترميز الموقع الذي سيتم استخدامه. يمكن أن يكون "trainable" أو "fourier" أو "none".
مفكّك ترميز فيديو ذاتي يعتمد على الانتباه المتقاطع. غلاف خفيف الوزن لـ [*PerceiverBasicDecoder*] يتضمن منطق إعادة تشكيل الفيديو.
## PerceiverMultimodalDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder(config: PerceiverConfig, modalities: dict[str, transformers.models.perceiver.modeling_perceiver.PerceiverAbstractDecoder], num_outputs: int, output_num_channels: int, min_padding_size: int | None = 2, subsampled_index_dims: dict[str, transformers.models.perceiver.modeling_perceiver.PerceiverAbstractDecoder] | None = None, **decoder_kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2206)
**المعاملات:**
config ([*PerceiverConfig*]) : إعدادات النموذج.
modalities (`dict[str, PerceiverAbstractDecoder]`) : قاموس يربط اسم النمط (modality) بفكّ الترميز (decoder) الخاص بذلك النمط.
num_outputs (`int`) : عدد مخرجات المُفكِّك.
output_num_channels (`int`) : عدد القنوات في المخرجات.
min_padding_size (`int`، *اختياري*، القيمة الافتراضية 2) : الحد الأدنى لحجم الحشو لجميع الأنماط. سيكون عدد القنوات في المخرجات النهائية مساويًا لأكبر عدد قنوات عبر جميع الأنماط مضافًا إليه min_padding_size.
subsampled_index_dims (`dict[str, PerceiverAbstractDecoder]`، *اختياري*) : قاموس يربط اسم النمط بأبعاد الفهرس المُخفَّض التي تُستخدم لاستعلام المُفكِّك الخاص بذلك النمط.
فك الترميز متعدد الوسائط من خلال تركيب مفككات الترميز أحادية الوسائط. يُعدّ الحجة *modalities* في منشئ الكائن قاموسًا يربط اسم كل وسيلة بمفكك الترميز الخاص بها. يُستخدم هذا المفكك لبناء الاستعلامات (queries) الخاصة بتلك الوسيلة. تُملأ الاستعلامات الخاصة بكل وسيلة بمعلمات قابلة للتدريب ومخصصة لتلك الوسيلة، ثم تُدمج (concatenate) على طول بُعد الزمن.
بعد ذلك، توجد عملية انتباه متقاطع مشتركة عبر جميع الأنماط.
## PerceiverProjectionPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor(in_channels: int, out_channels: int)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2804)
**المعاملات:**
in_channels (`int`) : عدد القنوات في المدخلات.
out_channels (`int`) : عدد القنوات في المخرجات.
معالجة ما بعد الإسقاط لـ Perceiver. يمكن استخدامه لإسقاط قنوات مخرج المُفكِّك إلى بُعد أدنى.
## PerceiverAudioPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor(config: PerceiverConfig, in_channels: int, postproc_type: str = 'patches')
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2777)
**المعاملات:**
config ([*PerceiverConfig*]) : إعدادات النموذج.
in_channels (`int`) : عدد القنوات في المدخلات.
postproc_type (`str`، *اختياري*، الافتراضي `"patches"`) : نوع المعالج ما بعد المعالجة (Postprocessor) المستخدم. حاليًا، يتم دعم "patches" فقط.
معالجة ما بعد الصوت لنموذج Perceiver. يمكن استخدامه لتحويل مخرجات المُفكِّك إلى ميزات صوتية.
## PerceiverClassificationPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor(config: PerceiverConfig, in_channels: int)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2757)
**المعاملات:**
config ([*PerceiverConfig*]) : إعدادات النموذج.
in_channels (`int`) : عدد القنوات في المدخلات.
معالجة ما بعد التصنيف لنموذج Perceiver. يمكن استخدامه لتحويل مخرج المُفكِّك إلى قيم احتمالات التصنيف.
## PerceiverMultimodalPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor(modalities: collections.abc.Mapping[str, collections.abc.Callable[..., typing.Any]], input_is_dict: bool = False)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2723)
**المعاملات:**
modalities (`Mapping[str, PostprocessorType]`) : قاموس يربط اسم النمط (modality) بفئة المعالج اللاحق (postprocessor) الخاصة بذلك النمط.
input_is_dict (`bool`، *اختياري*، القيمة الافتراضية `False`) : إذا كانت القيمة True، يُفترض أن المدخلات ذات بنية قاموسية، وتحتفظ المخرجات بنفس شكل القاموس. أما إذا كانت False، فإن المدخلات هي متجه (tensor) يتم تقطيعه أثناء المعالجة اللاحقة بواسطة *modality_sizes*.
معالجة لاحقة متعددة الوسائط لـ Perceiver. يمكن استخدامه لدمج المعالجات اللاحقة الخاصة بكل نمط في معالج لاحق واحد.
## PerceiverModel[[transformers.PerceiverModel]]
#### transformers.PerceiverModel[[transformers.PerceiverModel]]
```python
transformers.PerceiverModel(config: PerceiverConfig, decoder: typing.Optional[ForwardRef('PerceiverAbstractDecoder')] = None, input_preprocessor: collections.abc.Callable[..., tuple[torch.Tensor, typing.Optional[torch.Tensor], torch.Tensor]] = None, output_postprocessor: collections.abc.Callable[..., typing.Any] = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L561)
**المعاملات:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
decoder (`PerceiverDecoder`، *اختياري*) : وحدة فك الترميز التي تحوّل التمثيلات الكامنة إلى تنبؤات المهمة.
input_preprocessor (`PreprocessorType`، *اختياري*) : مُعالج مسبق يرمّز المدخلات الخام إلى متجهات (تensors) للنموذج.
output_postprocessor (`PostprocessorType`، *اختياري*) : مُعالج ما بعد المعالجة يحوّل مخرجات النموذج إلى تنبؤات نهائية.
المُدرِك: بنية قابلة للتوسع وتعتمد بالكامل على آلية الانتباه.
لاحظ أنه من الممكن ضبط Perceiver على صور بدقة أعلى من تلك التي تم تدريبه عليها، وذلك بإعداد `interpolate_pos_encoding` إلى `True` في استدعاء النموذج. سيؤدي هذا إلى استيفاء ترميزات المواقع المُدرَّبة مسبقًا لتتوافق مع الدقة الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.PerceiverModel.forward]]
```python
forward(inputs: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, subsampled_output_points: dict[str, torch.Tensor] | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, interpolate_pos_encoding: bool = False, return_dict: bool | None = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L597)
**المعاملات:**
inputs (`torch.Tensor`) : المدخلات إلى المُدرِك (perceiver). يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
subsampled_output_points (`dict[str, torch.Tensor]`، *اختياري*) : قاموس من الموترات (tensors) تُستخدم كاستعلامات (queries) لفك الترميز. يقوم فك الترميز بربط هذه الاستعلامات بالتعبير الكامن (latent representation) للنموذج. يُستخدم لفك الترميز المُجزّأ (subsampled decoding)، على سبيل المثال عند فك ترميز بعض رقعات الصورة (image patches) فقط.
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** [PerceiverModelOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput) أو `tuple(torch.Tensor)`
[PerceiverModelOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) والمدخلات.
تتجاوز طريقة [PerceiverModel](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverModel) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **logits** (`torch.Tensor` من الشكل `(batch_size, num_labels)`) -- درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).
- **last_hidden_state** (`torch.Tensor` بأبعاد `(batch_size, sequence_length, hidden_size)`، *اختياري*) -- تسلسل من الحالات المخفية عند مخرجات الطبقة الأخيرة من النموذج.
- **hidden_states** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة (Tuple) من `torch.Tensor` (واحدة لكل من مخرجات الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لكل من مخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في طبقة الانتباه المتقاطع للمفكّك، بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجّح في رؤوس الانتباه المتقاطع.
أمثلة:
```python
>>> from transformers import PerceiverConfig, PerceiverTokenizer, PerceiverImageProcessor, PerceiverModel
>>> from transformers.models.perceiver.modeling_perceiver import (
... PerceiverTextPreprocessor,
... PerceiverImagePreprocessor,
... PerceiverClassificationDecoder,
... )
>>> import torch
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> # EXAMPLE 1: using the Perceiver to classify texts
>>> # - we define a TextPreprocessor, which can be used to embed tokens
>>> # - we define a ClassificationDecoder, which can be used to decode the
>>> # final hidden states of the latents to classification logits
>>> # using trainable position embeddings
>>> config = PerceiverConfig()
>>> preprocessor = PerceiverTextPreprocessor(config)
>>> decoder = PerceiverClassificationDecoder(
... config,
... num_channels=config.d_latents,
... trainable_position_encoding_kwargs=dict(num_channels=config.d_latents, index_dims=1),
... use_query_residual=True,
... )
>>> model = PerceiverModel(config, input_preprocessor=preprocessor, decoder=decoder)
>>> # you can then do a forward pass as follows:
>>> tokenizer = PerceiverTokenizer()
>>> text = "hello world"
>>> inputs = tokenizer(text, return_tensors="pt").input_ids
>>> with torch.no_grad():
... outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
>>> # to train, one can train the model using standard cross-entropy:
>>> criterion = torch.nn.CrossEntropyLoss()
>>> labels = torch.tensor([1])
>>> loss = criterion(logits, labels)
>>> # EXAMPLE 2: using the Perceiver to classify images
>>> # - we define an ImagePreprocessor, which can be used to embed images
>>> config = PerceiverConfig(image_size=224)
>>> preprocessor = PerceiverImagePreprocessor(
... config,
... prep_type="conv1x1",
... spatial_downsample=1,
... out_channels=256,
... position_encoding_type="trainable",
... concat_or_add_pos="concat",
... project_pos_dim=256,
... trainable_position_encoding_kwargs=dict(
... num_channels=256,
... index_dims=config.image_size**2,
... ),
... )
>>> model = PerceiverModel(
... config,
... input_preprocessor=preprocessor,
... decoder=PerceiverClassificationDecoder(
... config,
... num_channels=config.d_latents,
... trainable_position_encoding_kwargs=dict(num_channels=config.d_latents, index_dims=1),
... use_query_residual=True,
... ),
... )
>>> # you can then do a forward pass as follows:
>>> image_processor = PerceiverImageProcessor()
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = image_processor(image, return_tensors="pt").pixel_values
>>> with torch.no_grad():
... outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
>>> # to train, one can train the model using standard cross-entropy:
>>> criterion = torch.nn.CrossEntropyLoss()
>>> labels = torch.tensor([1])
>>> loss = criterion(logits, labels)
```
## PerceiverForMaskedLM[[transformers.PerceiverForMaskedLM]]
#### transformers.PerceiverForMaskedLM[[transformers.PerceiverForMaskedLM]]
```python
transformers.PerceiverForMaskedLM(config: PerceiverConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L807)
**المعاملات:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
مثال على استخدام Perceiver لنمذجة اللغة المقنّعة.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.PerceiverForMaskedLM.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, input_ids: typing.Optional[torch.Tensor] = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L839)
**المعاملات:**
inputs (`torch.Tensor`، *اختياري*) : المدخلات إلى المُدرِك (perceiver). يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
labels (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : التسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس ضمن `[-100, 0, ..., config.vocab_size]` (انظر `input_ids` docstring). يتم تجاهل الرموز التي تكون فهارسها مضبوطة على `-100` (مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن `[0, ..., config.vocab_size]`.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
**يعيد:** [PerceiverMaskedLMOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput) أو `tuple(torch.Tensor)`
[PerceiverMaskedLMOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) والمدخلات.
تتجاوز طريقة [PerceiverForMaskedLM](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverForMaskedLM) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`، *اختياري*، يُعاد عند توفير `labels`) -- خسارة نمذجة اللغة المقنّعة (MLM).
- **logits** (`torch.Tensor` من الشكل `(batch_size, sequence_length, config.vocab_size)`) -- درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة (Tuple) من `torch.Tensor` (واحدة لكل من مخرجات الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لكل من مخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في طبقة الانتباه المتقاطع للمفكّك، بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجّح في رؤوس الانتباه المتقاطع.
أمثلة:
```python
>>> from transformers import AutoTokenizer, PerceiverForMaskedLM
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("deepmind/language-perceiver")
>>> model = PerceiverForMaskedLM.from_pretrained("deepmind/language-perceiver")
>>> # training
>>> text = "This is an incomplete sentence where some words are missing."
>>> inputs = tokenizer(text, padding="max_length", return_tensors="pt")
>>> # mask " missing."
>>> inputs["input_ids"][0, 52:61] = tokenizer.mask_token_id
>>> labels = tokenizer(text, padding="max_length", return_tensors="pt").input_ids
>>> outputs = model(**inputs, labels=labels)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
19.87
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2048, 262]
>>> # inference
>>> text = "This is an incomplete sentence where some words are missing."
>>> encoding = tokenizer(text, padding="max_length", return_tensors="pt")
>>> # mask bytes corresponding to " missing.". Note that the model performs much better if the masked span starts with a space.
>>> encoding["input_ids"][0, 52:61] = tokenizer.mask_token_id
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2048, 262]
>>> masked_tokens_predictions = logits[0, 52:61].argmax(dim=-1).tolist()
>>> tokenizer.decode(masked_tokens_predictions)
' missing.'
```
## PerceiverForSequenceClassification[[transformers.PerceiverForSequenceClassification]]
#### transformers.PerceiverForSequenceClassification[[transformers.PerceiverForSequenceClassification]]
```python
transformers.PerceiverForSequenceClassification(config: PerceiverConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L940)
**المعاملات:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
مثال على استخدام Perceiver لتصنيف النصوص.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.PerceiverForSequenceClassification.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, input_ids: typing.Optional[torch.Tensor] = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L961)
**المعاملات:**
inputs (`torch.Tensor`، *اختياري*) : المدخلات إلى المُدرِك (perceiver). يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
labels (`torch.LongTensor` من الشكل `(batch_size,)`، *اختياري*) : تسميات لحساب خسارة التصنيف/الانحدار. يجب أن تكون الفهارس ضمن `[0, ..., config.num_labels - 1]`. إذا كان `config.num_labels == 1` يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كان `config.num_labels > 1` يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة).
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
**يعيد:** [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) أو `tuple(torch.Tensor)`
[PerceiverClassifierOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) والمدخلات.
تُعيد طريقة [PerceiverForSequenceClassification](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverForSequenceClassification) الخاصة بالتقديم (forward) تعريف الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`, *اختياري*، يُعاد عند تقديم `labels`) -- خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).
- **logits** (`torch.Tensor` من الشكل `(batch_size, config.num_labels)`) -- درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة (Tuple) من `torch.Tensor` (واحدة لكل من مخرجات الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لكل من مخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في طبقة الانتباه المتقاطع للمفكّك، بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجّح في رؤوس الانتباه المتقاطع.
أمثلة:
```python
>>> from transformers import AutoTokenizer, PerceiverForSequenceClassification
>>> tokenizer = AutoTokenizer.from_pretrained("deepmind/language-perceiver")
>>> model = PerceiverForSequenceClassification.from_pretrained("deepmind/language-perceiver")
>>> text = "hello world"
>>> inputs = tokenizer(text, return_tensors="pt").input_ids
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
```
## PerceiverForImageClassificationLearned[[transformers.PerceiverForImageClassificationLearned]]
#### transformers.PerceiverForImageClassificationLearned[[transformers.PerceiverForImageClassificationLearned]]
```python
transformers.PerceiverForImageClassificationLearned(config: PerceiverConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1062)
**المعاملات:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
مثال على استخدام Perceiver لتصنيف الصور، لمهام مثل ImageNet.
يستخدم هذا النموذج تضمينات مواقع متعلمة. بمعنى آخر، لا يُمنح هذا النموذج أي معلومات مفضلة حول بنية الصور. وكما هو موضح في الورقة البحثية، يمكن لهذا النموذج تحقيق دقة أعلى تصنيف بنسبة 72.7 على ImageNet.
يستخدم [PerceiverForImageClassificationLearned](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) المعالج المسبق [PerceiverImagePreprocessor](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (مع `prep_type="conv1x1"`) لمعالجة الصور المدخلة مسبقاً، و[PerceiverClassificationDecoder](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder) لفك ترميز التمثيل الكامن لـ[PerceiverModel](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverModel) إلى قيم التصنيف (logits).
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.PerceiverForImageClassificationLearned.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, return_dict: bool | None = None, pixel_values: typing.Optional[torch.Tensor] = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1093)
**المعاملات:**
inputs (`torch.Tensor`، *اختياري*) : المدخلات إلى المُدرِك (perceiver). يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
labels (من نوع `torch.LongTensor` بأبعاد `(batch_size,)`، *اختياري*) : تسميات لحساب خسارة تصنيف/الانحدار للصور. يجب أن تكون الفهارس ضمن `[0, ..., config.num_labels - 1]`. إذا كان `config.num_labels == 1` يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كان `config.num_labels > 1` يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة).
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام [PerceiverImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverImageProcessor). راجع [PerceiverImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل (`processor_class` يستخدم [PerceiverImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverImageProcessor) لمعالجة الصور).
**يعيد:** [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) أو `tuple(torch.Tensor)`
[PerceiverClassifierOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) والمدخلات.
تتجاوز طريقة [PerceiverForImageClassificationLearned](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`, *اختياري*، يُعاد عند تقديم `labels`) -- خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).
- **logits** (`torch.Tensor` من الشكل `(batch_size, config.num_labels)`) -- درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة (Tuple) من `torch.Tensor` (واحدة لكل من مخرجات الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لكل من مخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في طبقة الانتباه المتقاطع للمفكّك، بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجّح في رؤوس الانتباه المتقاطع.
أمثلة:
```python
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationLearned
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-learned")
>>> model = PerceiverForImageClassificationLearned.from_pretrained("deepmind/vision-perceiver-learned")
>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
```
## PerceiverForImageClassificationFourier[[transformers.PerceiverForImageClassificationFourier]]
#### transformers.PerceiverForImageClassificationFourier[[transformers.PerceiverForImageClassificationFourier]]
```python
transformers.PerceiverForImageClassificationFourier(config: PerceiverConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1187)
**المعاملات:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
مثال على استخدام Perceiver لتصنيف الصور، لمهام مثل ImageNet.
يستخدم هذا النموذج تضمينات موضع ثنائية الأبعاد ثابتة من نوع فورييه. وكما هو موضح في الورقة البحثية، يمكن لهذا النموذج تحقيق دقة أعلى تصنيف بنسبة 79.0 على ImageNet، و84.5 عند تدريبه مسبقًا على مجموعة بيانات واسعة النطاق (أي JFT).
يستخدم [PerceiverForImageClassificationLearned](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) المعالج المسبق [PerceiverImagePreprocessor](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (مع `prep_type="pixels"`) لمعالجة الصور المدخلة مسبقاً، ويستخدم [PerceiverClassificationDecoder](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder) لفك الترميز التمثيلي الكامن لـ [PerceiverModel](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverModel) إلى قيم التصنيف (logits).
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.PerceiverForImageClassificationFourier.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, pixel_values: typing.Optional[torch.Tensor] = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1219)
**المعاملات:**
inputs (`torch.Tensor`، *اختياري*) : المدخلات إلى المُدرِك (perceiver). يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
labels (من نوع `torch.LongTensor` بأبعاد `(batch_size,)`، *اختياري*) : تسميات لحساب خسارة تصنيف/الانحدار للصور. يجب أن تكون الفهارس ضمن `[0, ..., config.num_labels - 1]`. إذا كان `config.num_labels == 1` يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كان `config.num_labels > 1` يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة).
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام [PerceiverImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverImageProcessor). راجع [PerceiverImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل (`processor_class` يستخدم [PerceiverImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverImageProcessor) لمعالجة الصور).
**يعيد:** [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) أو `tuple(torch.Tensor)`
[PerceiverClassifierOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) والمدخلات.
تتجاوز طريقة [PerceiverForImageClassificationFourier](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverForImageClassificationFourier) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`, *اختياري*، يُعاد عند تقديم `labels`) -- خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).
- **logits** (`torch.Tensor` من الشكل `(batch_size, config.num_labels)`) -- درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة (Tuple) من `torch.Tensor` (واحدة لكل من مخرجات الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لكل من مخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في طبقة الانتباه المتقاطع للمفكّك، بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجّح في رؤوس الانتباه المتقاطع.
أمثلة:
```python
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationFourier
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-fourier")
>>> model = PerceiverForImageClassificationFourier.from_pretrained("deepmind/vision-perceiver-fourier")
>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
```
## PerceiverForImageClassificationConvProcessing[[transformers.PerceiverForImageClassificationConvProcessing]]
#### transformers.PerceiverForImageClassificationConvProcessing[[transformers.PerceiverForImageClassificationConvProcessing]]
```python
transformers.PerceiverForImageClassificationConvProcessing(config: PerceiverConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1310)
**المعاملات:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
مثال على استخدام Perceiver لتصنيف الصور، لمهام مثل ImageNet.
يستخدم هذا النموذج شبكة معالجة مسبقة تعتمد على التمرير ثنائي الأبعاد conv مع maxpool. وكما هو موضح في الورقة البحثية، يمكن لهذا النموذج تحقيق دقة من الدرجة الأولى (top-1) تبلغ 82.1 على مجموعة بيانات ImageNet.
يستخدم [PerceiverForImageClassificationLearned](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) المعالج المسبق [PerceiverImagePreprocessor](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (مع `prep_type="conv"`) لمعالجة الصور المدخلة مسبقاً، ويستخدم [PerceiverClassificationDecoder](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder) لفك ترميز التمثيل الكامن لـ [PerceiverModel](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverModel) إلى قيم التصنيف (logits).
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.PerceiverForImageClassificationConvProcessing.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, pixel_values: typing.Optional[torch.Tensor] = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1343)
**المعاملات:**
inputs (`torch.Tensor`، *اختياري*) : المدخلات إلى المُدرِك (perceiver). يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
labels (من نوع `torch.LongTensor` بأبعاد `(batch_size,)`، *اختياري*) : تسميات لحساب خسارة تصنيف/الانحدار للصور. يجب أن تكون الفهارس ضمن `[0, ..., config.num_labels - 1]`. إذا كان `config.num_labels == 1` يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كان `config.num_labels > 1` يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة).
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام [PerceiverImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverImageProcessor). راجع [PerceiverImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل (`processor_class` يستخدم [PerceiverImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverImageProcessor) لمعالجة الصور).
**يعيد:** [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) أو `tuple(torch.Tensor)`
[PerceiverClassifierOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) والمدخلات.
تتجاوز طريقة [PerceiverForImageClassificationConvProcessing](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverForImageClassificationConvProcessing) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`, *اختياري*، يُعاد عند تقديم `labels`) -- خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).
- **logits** (`torch.Tensor` من الشكل `(batch_size, config.num_labels)`) -- درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة (Tuple) من `torch.Tensor` (واحدة لكل من مخرجات الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لكل من مخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في طبقة الانتباه المتقاطع للمفكّك، بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجّح في رؤوس الانتباه المتقاطع.
أمثلة:
```python
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationConvProcessing
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-conv")
>>> model = PerceiverForImageClassificationConvProcessing.from_pretrained("deepmind/vision-perceiver-conv")
>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
```
## PerceiverForOpticalFlow[[transformers.PerceiverForOpticalFlow]]
#### transformers.PerceiverForOpticalFlow[[transformers.PerceiverForOpticalFlow]]
```python
transformers.PerceiverForOpticalFlow(config: PerceiverConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1434)
**المعاملات:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
مثال على استخدام Perceiver لتدفق الضوء، لمهام مثل Sintel وKITTI. يستخدم [PerceiverForOpticalFlow](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverForOpticalFlow) [PerceiverImagePreprocessor](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (مع *prep_type="patches"*) لمعالجة الصور المدخلة مسبقاً، و [PerceiverOpticalFlowDecoder](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder) لفك ترميز التمثيل الكامن لـ [PerceiverModel](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverModel).
كمدخل، يتم دمج إطارين متتاليين على طول بُعد القناة واستخراج رقعة 3 x 3 حول كل بكسل (مما يؤدي إلى 3 x 3 x 3 x 2 = 54 قيمة لكل بكسل). تُستخدم ترميزات موضع فورييه ثابتة لترميز موضع كل بكسل داخل الرقعة. بعد ذلك، يُطبق مُرمِّز Perceiver. ولإجراء فك الترميز، يُستعلم عن التمثيل الكامن باستخدام نفس الترميز المستخدم للمدخل.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.PerceiverForOpticalFlow.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1484)
**المعاملات:**
inputs (`torch.Tensor`، *اختياري*) : المدخلات إلى المُدرِك (perceiver). يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
labels (`torch.LongTensor` من الشكل `(batch_size,)`، *اختياري*) : تسميات لحساب خسارة التدفق البصري. يجب أن تكون الفهارس ضمن `[0, ..., config.num_labels - 1]`.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) أو `tuple(torch.Tensor)`
[PerceiverClassifierOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) والمدخلات.
تُعيد طريقة [PerceiverForOpticalFlow](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverForOpticalFlow) الخاصة بالتقديم (forward) تعريف الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`, *اختياري*، يُعاد عند تقديم `labels`) -- خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).
- **logits** (`torch.Tensor` من الشكل `(batch_size, config.num_labels)`) -- درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة (Tuple) من `torch.Tensor` (واحدة لكل من مخرجات الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لكل من مخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في طبقة الانتباه المتقاطع للمفكّك، بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجّح في رؤوس الانتباه المتقاطع.
أمثلة:
```python
>>> from transformers import PerceiverForOpticalFlow
>>> import torch
>>> model = PerceiverForOpticalFlow.from_pretrained("deepmind/optical-flow-perceiver")
>>> # in the Perceiver IO paper, the authors extract a 3 x 3 patch around each pixel,
>>> # leading to 3 x 3 x 3 = 27 values for each pixel (as each pixel also has 3 color channels)
>>> # patches have shape (batch_size, num_frames, num_channels, height, width)
>>> # the authors train on resolutions of 368 x 496
>>> patches = torch.randn(1, 2, 27, 368, 496)
>>> outputs = model(inputs=patches)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 368, 496, 2]
```
## PerceiverForMultimodalAutoencoding[[transformers.PerceiverForMultimodalAutoencoding]]
#### transformers.PerceiverForMultimodalAutoencoding[[transformers.PerceiverForMultimodalAutoencoding]]
```python
transformers.PerceiverForMultimodalAutoencoding(config: PerceiverConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1576)
**المعاملات:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
مثال على استخدام Perceiver للتشفير التلقائي متعدد الوسائط (فيديو)، لمهام مثل Kinetics-700.
يستخدم [PerceiverForMultimodalAutoencoding](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverForMultimodalAutoencoding) المعالج المسبق [PerceiverMultimodalPreprocessor](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor) لمعالجة الأنماط الثلاثة: الصور والصوت ووسوم الفئات. يستخدم هذا المعالج المسبق معالجات مسبقة مخصصة لكل نمط لمعالجة كل نمط على حدة، ثم يتم دمجها. تُستخدم تضمينات المواقع القابلة للتدريب لتعبئة كل نمط إلى نفس عدد القنوات لجعل الدمج على طول بُعد الزمن ممكنًا. بعد ذلك، يُطبق مُشفِّر Perceiver.
يُستخدم [PerceiverMultimodalDecoder](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder) لفك ترميز التمثيل الكامن لـ [PerceiverModel](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverModel). يستخدم هذا المُفكّك مُفكّكًا خاصًا بكل نمط لبناء الاستعلامات. تُنشأ استعلامات المُفكّك بناءً على المدخلات بعد المعالجة المسبقة. ومع ذلك، فإن فك ترميز فيديو كامل في مسار أمامي واحد غير ممكن من الناحية الحسابية، لذا يُستخدم جزء فقط من استعلامات المُفكّك لتنفيذ الانتباه المتقاطع مع التمثيل الكامن. يُحدَّد ذلك بواسطة الفهارس المُعيَّنة لكل نمط، والتي يمكن تقديمها كمدخل إضافي للمسار الأمامي لـ [PerceiverForMultimodalAutoencoding](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverForMultimodalAutoencoding).
يقوم [PerceiverMultimodalDecoder](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder) أيضًا بتعبئة استعلامات المُفكِّك الخاصة بالأنماط المختلفة إلى نفس عدد القنوات، من أجل دمجها على طول بُعد الزمن. ثم يتم تنفيذ الانتباه المتقاطع مع التمثيل الكامن لـ [PerceiverModel](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverModel).
أخيرًا، يُستخدم `~models.perceiver.modeling_perceiver.PerceiverMultiModalPostprocessor` لتحويل هذا المصفوفة إلى فيديو فعلي. يقوم أولًا بتقسيم المخرجات إلى الأنماط المختلفة، ثم يطبّق المعالج اللاحق المناسب لكل نمط.
لاحظ أنه، عن طريق إخفاء تسمية التصنيف أثناء التقييم (أي ببساطة تقديم متجه من الأصفار لخاصية "label")، يصبح هذا النموذج الترميزي التلقائي مصنفًا للفيديو من نوع Kinetics 700.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.PerceiverForMultimodalAutoencoding.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, subsampled_output_points: dict[str, torch.Tensor] | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1692)
**المعاملات:**
inputs (`torch.Tensor`، *اختياري*) : المدخلات إلى المُدرِك (perceiver). يمكن أن تكون أي شيء: صور، نصوص، صوت، فيديو، إلخ.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
subsampled_output_points (`dict[str, torch.Tensor]`، *اختياري*) : قاموس من الموترات (tensors) تُستخدم كاستعلامات (queries) لفك الترميز. يقوم فك الترميز بربط هذه الاستعلامات بالتعبير الكامن (latent representation) للنموذج. يُستخدم لفك الترميز المُجزّأ (subsampled decoding)، على سبيل المثال عند فك ترميز بعض رقعات الصورة (image patches) فقط.
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
labels (من نوع `torch.LongTensor` بأبعاد `(batch_size,)`، *اختياري*) : تسميات لحساب خسارة تصنيف/الانحدار للصور. يجب أن تكون الفهارس ضمن `[0, ..., config.num_labels - 1]`. إذا كان `config.num_labels == 1` يتم حساب خسارة الانحدار (خسارة متوسط المربع)، وإذا كان `config.num_labels > 1` يتم حساب خسارة التصنيف (الإنتروبيا المتقاطعة).
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) أو `tuple(torch.Tensor)`
[PerceiverClassifierOutput](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([PerceiverConfig](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverConfig)) والمدخلات.
تتجاوز طريقة [PerceiverForMultimodalAutoencoding](/docs/transformers/v5.23.0/ar/model_doc/perceiver#transformers.PerceiverForMultimodalAutoencoding) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`, *اختياري*، يُعاد عند تقديم `labels`) -- خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).
- **logits** (`torch.Tensor` من الشكل `(batch_size, config.num_labels)`) -- درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة (Tuple) من `torch.Tensor` (واحدة لكل من مخرجات الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لكل من مخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple[torch.Tensor]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في طبقة الانتباه المتقاطع للمفكّك، بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجّح في رؤوس الانتباه المتقاطع.
أمثلة:
```python
>>> from transformers import PerceiverForMultimodalAutoencoding
>>> import torch
>>> import numpy as np
>>> # create multimodal inputs
>>> images = torch.randn((1, 16, 3, 224, 224))
>>> audio = torch.randn((1, 30720, 1))
>>> inputs = dict(image=images, audio=audio, label=torch.zeros((images.shape[0], 700)))
>>> model = PerceiverForMultimodalAutoencoding.from_pretrained("deepmind/multimodal-perceiver")
>>> # in the Perceiver IO paper, videos are auto-encoded in chunks
>>> # each chunk subsamples different index dimensions of the image and audio modality decoder queries
>>> nchunks = 128
>>> image_chunk_size = np.prod((16, 224, 224)) // nchunks
>>> audio_chunk_size = audio.shape[1] // model.config.samples_per_patch // nchunks
>>> # process the first chunk
>>> chunk_idx = 0
>>> subsampling = {
... "image": torch.arange(image_chunk_size * chunk_idx, image_chunk_size * (chunk_idx + 1)),
... "audio": torch.arange(audio_chunk_size * chunk_idx, audio_chunk_size * (chunk_idx + 1)),
... "label": None,
... }
>>> outputs = model(inputs=inputs, subsampled_output_points=subsampling)
>>> logits = outputs.logits
>>> list(logits["audio"].shape)
[1, 240]
>>> list(logits["image"].shape)
[1, 6272, 3]
>>> list(logits["label"].shape)
[1, 700]
```