# CLIPSeg
## نظرة عامة
قُدِّم نموذج CLIPSeg في [Image Segmentation Using Text and Image Prompts](https://huggingface.co/papers/2112.10003) من قِبل Timo Lüddecke وAlexander Ecker. يضيف CLIPSeg مُفكِّكًا (decoder) بسيطًا فوق نموذج [CLIP](clip) مجمَّد لأغراض تقسيم الصور بدون تدريب مسبق (zero-shot) أو بتدريب على مثال واحد (one-shot).
المستخلص من الورقة البحثية هو كالتالي:
*عادةً ما يُعالج تقطيع الصور من خلال تدريب نموذج على مجموعة ثابتة من فئات الكائنات. يُعدّ دمج فئات إضافية أو استعلامات أكثر تعقيداً لاحقاً مكلفاً، إذ يتطلب إعادة تدريب النموذج على مجموعة بيانات تشمل هذه التعبيرات. هنا نقترح نظاماً قادراً على توليد تقطيعات للصور بناءً على أوامر (prompts) اختيارية في وقت الاختبار. يمكن أن يكون الأمر عبارة عن نص أو صورة. تُمكّننا هذه المنهجية من إنشاء نموذج موحّد (يُدرَّب مرة واحدة) لثلاث مهام شائعة لتقطيع الصور، التي تأتي مع تحديات متميزة: تقطيع تعبيرات الإشارة (referring expression segmentation)، والتقطيع بدون أمثلة (zero-shot segmentation)، والتقطيع بمثال واحد (one-shot segmentation). نبني على نموذج CLIP كهيكل أساسي، نوسّعه بمفكّك (decoder) يعتمد على المحوّلات (transformer) يتيح التنبؤ الكثيف (dense prediction). بعد التدريب على نسخة موسّعة من مجموعة بيانات PhraseCut، يولّد نظامنا خريطة تقطيع ثنائية (binary segmentation map) لصورة بناءً على أمر نصي حر أو على صورة إضافية تعبّر عن الاستعلام. نحلّل بالتفصيل متغيرات مختلفة من أوامر الصور هذه. يسمح هذا الإدخال الهجين الجديد بالتكيّف الديناميكي ليس فقط مع مهام التقطيع الثلاثة المذكورة أعلاه، بل مع أي مهمة تقطيع ثنائية يمكن صياغة استعلام نصي أو بصري لها. أخيراً، نجد أن نظامنا يتكيّف بشكل جيد مع الاستعلامات العامة التي تتضمن القدرات (affordances) أو الخصائص*
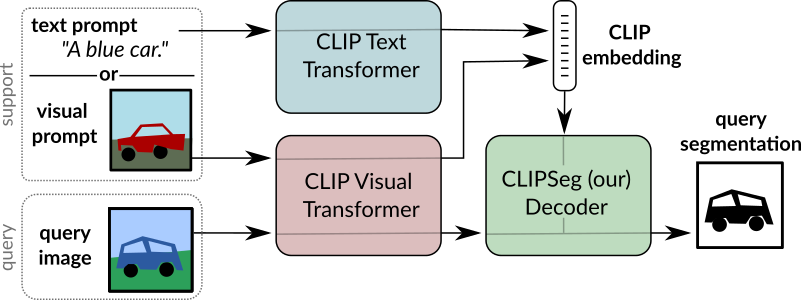 نظرة عامة على CLIPSeg. مأخوذة من الورقة الأصلية.
تمت مساهمة هذا النموذج من قِبل [nielsr](https://huggingface.co/nielsr). يمكن العثور على الكود الأصلي [هنا](https://github.com/timojl/clipseg).
## نصائح للاستخدام
- يضيف [CLIPSegForImageSegmentation](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) مُفكّكاً (decoder) فوق [CLIPSegModel](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegModel). والأخير مطابق تماماً لـ [CLIPModel](/docs/transformers/v5.23.0/ar/model_doc/clip#transformers.CLIPModel).
- يمكن لـ [CLIPSegForImageSegmentation](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) توليد تقسيمات للصور بناءً على أوامر اختيارية في وقت الاختبار. يمكن أن يكون الأمر نصًا
(يُقدَّم إلى النموذج على شكل `input_ids`) أو صورة (تُقدَّم إلى النموذج على شكل `conditional_pixel_values`). كما يمكن تقديم تضمينات شرطية مخصصة (تُقدَّم إلى النموذج على شكل `conditional_embeddings`).
## الموارد
قائمة بالموارد الرسمية من Hugging Face وموارد المجتمع (المشار إليها بـ 🌎) لمساعدتك على البدء مع CLIPSeg. إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب (Pull Request) وسنقوم بمراجعته! يُفضَّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
- دفتر ملاحظات يوضح [تجزئة الصور بدون تدريب باستخدام CLIPSeg](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/CLIPSeg/Zero_shot_image_segmentation_with_CLIPSeg.ipynb).
## CLIPSegConfig[[transformers.CLIPSegConfig]]
#### transformers.CLIPSegConfig[[transformers.CLIPSegConfig]]
```python
transformers.CLIPSegConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, text_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegTextConfig | None = None, vision_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegVisionConfig | None = None, projection_dim: int | None = 512, logit_scale_init_value: float | int | None = 2.6592, initializer_factor: float | None = 1.0, extract_layers: list[int] | tuple[int, ...] = (3, 6, 9), reduce_dim: int = 64, decoder_num_attention_heads: int = 4, decoder_attention_dropout: float | int = 0.0, decoder_hidden_act: str = 'quick_gelu', decoder_intermediate_size: int = 2048, conditional_layer: int = 0, use_complex_transposed_convolution: bool = False)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/configuration_clipseg.py#L124)
**المعاملات:**
text_config (`Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegTextConfig]`, *اختياري*) : كائن الإعدادات أو قاموس العمود الفقري النصي.
vision_config (`Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegVisionConfig]`, *اختياري*) : كائن الإعدادات أو قاموس العمود الفقري البصري.
projection_dim (`int`، *اختياري*، القيمة الافتراضية `512`) : بُعد طبقات الإسقاط للنص والرؤية.
logit_scale_init_value (`Union[float, int]`، *اختياري*، القيمة الافتراضية `2.6592`) : القيمة الأولية لمعامل *logit_scale*.
initializer_factor (`float`، *اختياري*، القيمة الافتراضية `1.0`) : معامل لتجميع جميع مصفوفات الأوزان (يجب إبقاؤه عند 1، ويُستخدم داخليًا لاختبارات التهيئة).
extract_layers (`list[int]`، *اختياري*، القيمة الافتراضية `[3, 6, 9]`) : الطبقات التي يتم استخراجها عند تمرير صورة الاستعلام عبر العمود الفقري البصري المتجمد لـ CLIP.
reduce_dim (`int`، *اختياري*، القيمة الافتراضية 64) : الأبعاد التي تُقلَّص إليها تمثيلات CLIP البصرية.
decoder_num_attention_heads (`int`، *اختياري*، القيمة الافتراضية `4`) : عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer.
decoder_attention_dropout (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.0`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
decoder_hidden_act (`str`، *اختياري*، القيمة الافتراضية `quick_gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
decoder_intermediate_size (`int`، *اختياري*، القيمة الافتراضية `2048`) : بُعد تمثيلات MLP.
conditional_layer (`int`, *اختياري*، القيمة الافتراضية 0) : الطبقة المستخدمة من مُشفِّر Transformer التي سيتم دمج تنشيطاتها مع تضمينات الشرط باستخدام FiLM (Feature-wise Linear Modulation). إذا كانت القيمة 0، تُستخدم الطبقة الأخيرة.
use_complex_transposed_convolution (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استخدام التفاف محوّر أكثر تعقيدًا في المُفكِّك، مما يتيح تجزئةً أكثر دقةً.
هذه فئة الإعدادات المخزنة لإعدادات نموذج CLIPSegModel. تُستخدم لاستحداث نموذج Clipseg وفقًا للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import CLIPSegConfig, CLIPSegModel
>>> # Initializing a CLIPSegConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegConfig()
>>> # Initializing a CLIPSegModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a CLIPSegConfig from a CLIPSegTextConfig and a CLIPSegVisionConfig
>>> # Initializing a CLIPSegText and CLIPSegVision configuration
>>> config_text = CLIPSegTextConfig()
>>> config_vision = CLIPSegVisionConfig()
>>> config = CLIPSegConfig(text_config=config_text, vision_config=config_vision)
```
## CLIPSegTextConfig[[transformers.CLIPSegTextConfig]]
#### transformers.CLIPSegTextConfig[[transformers.CLIPSegTextConfig]]
```python
transformers.CLIPSegTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 77, hidden_act: str = 'quick_gelu', layer_norm_eps: float | None = 1e-05, attention_dropout: int | float | None = 0.0, initializer_range: float = 0.02, initializer_factor: float | None = 1.0, pad_token_id: int | None = 1, bos_token_id: int | None = 49406, eos_token_id: int | list[int] | None = 49407)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/configuration_clipseg.py#L31)
**المعاملات:**
vocab_size (`int`، *اختياري*، القيمة الافتراضية `49408`) : حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطة `input_ids`.
hidden_size (`int`، *اختياري*، القيمة الافتراضية `512`) : بُعد التمثيلات المخفية.
intermediate_size (`int`، *اختياري*، القيمة الافتراضية `2048`) : بُعد تمثيلات MLP.
num_hidden_layers (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد الطبقات المخفية في مُفكِّك Transformer.
num_attention_heads (`int`، *اختياري*، القيمة الافتراضية `8`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
max_position_embeddings (`int`، *اختياري*، القيمة الافتراضية `77`) : الحد الأقصى لطول التسلسل الذي قد يُستخدم به هذا النموذج.
hidden_act (`str`، *اختياري*، القيمة الافتراضية `quick_gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
layer_norm_eps (`float`، *اختياري*، القيمة الافتراضية `1e-05`) : قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
attention_dropout (`Union[int, float]`، *اختياري*، القيمة الافتراضية `0.0`) : نسبة dropout لاحتمالات الانتباه.
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
initializer_factor (`float`، *اختياري*، القيمة الافتراضية `1.0`) : معامل لتجميع جميع مصفوفات الأوزان (يجب إبقاؤه عند 1، ويُستخدم داخليًا لاختبارات التهيئة).
pad_token_id (`int`، *اختياري*، القيمة الافتراضية `1`) : معرّف الرمز المستخدم للتعبئة في المفردات.
bos_token_id (`int`، *اختياري*، القيمة الافتراضية `49406`) : معرّف الرمز المستخدم لبدء البث في المفردات.
eos_token_id (`Union[int, list[int]]`، *اختياري*، القيمة الافتراضية `49407`) : معرّف الرمز المستخدم لنهاية البث في المفردات.
هذه فئة الإعدادات المخزنة لإعدادات نموذج CLIPSegModel. تُستخدم لاستحداث نموذج Clipseg وفقًا للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import CLIPSegTextConfig, CLIPSegTextModel
>>> # Initializing a CLIPSegTextConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegTextConfig()
>>> # Initializing a CLIPSegTextModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegTextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## CLIPSegVisionConfig[[transformers.CLIPSegVisionConfig]]
#### transformers.CLIPSegVisionConfig[[transformers.CLIPSegVisionConfig]]
```python
transformers.CLIPSegVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] | None = 224, patch_size: int | list[int] | tuple[int, int] | None = 32, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: int | float | None = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/configuration_clipseg.py#L80)
**المعاملات:**
hidden_size (`int`، *اختياري*، القيمة الافتراضية `768`) : بُعد التمثيلات المخفية.
intermediate_size (`int`، *اختياري*، القيمة الافتراضية `3072`) : بُعد تمثيلات MLP.
num_hidden_layers (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد الطبقات المخفية في مُفكِّك Transformer.
num_attention_heads (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
num_channels (`int`، *اختياري*، القيمة الافتراضية `3`) : عدد قنوات الإدخال.
image_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية `224`) : حجم (دقة) كل صورة.
patch_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية `32`) : حجم (دقة) كل رقعة.
hidden_act (`str`، *اختياري*، القيمة الافتراضية `quick_gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
layer_norm_eps (`float`، *اختياري*، القيمة الافتراضية `1e-05`) : قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
attention_dropout (`Union[int, float]`، *اختياري*، القيمة الافتراضية `0.0`) : نسبة dropout لاحتمالات الانتباه.
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
initializer_factor (`float`، *اختياري*، القيمة الافتراضية `1.0`) : معامل لتجميع جميع مصفوفات الأوزان (يجب إبقاؤه عند 1، ويُستخدم داخليًا لاختبارات التهيئة).
هذه فئة الإعدادات المخزنة لإعدادات نموذج CLIPSegModel. تُستخدم لاستحداث نموذج Clipseg وفقًا للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import CLIPSegVisionConfig, CLIPSegVisionModel
>>> # Initializing a CLIPSegVisionConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegVisionConfig()
>>> # Initializing a CLIPSegVisionModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## CLIPSegProcessor[[transformers.CLIPSegProcessor]]
#### transformers.CLIPSegProcessor[[transformers.CLIPSegProcessor]]
```python
transformers.CLIPSegProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/processing_clipseg.py#L24)
**المعاملات:**
image_processor (`ViTImageProcessor`) : مُعالج الصور هو مدخل مطلوب.
tokenizer (`CLIPTokenizer`) : مُجزِّئ الرموز هو مدخل مطلوب.
ينشئ CLIPSegProcessor الذي يجمع معالج الصور ومعالج الرموز في معالج واحد.
يوفر [CLIPSegProcessor](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegProcessor) جميع وظائف [ViTImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vit#transformers.ViTImageProcessor) و[CLIPTokenizer](/docs/transformers/v5.23.0/ar/model_doc/clip#transformers.CLIPTokenizer). راجع [~ViTImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vit#transformers.ViTImageProcessor) و[~CLIPTokenizer](/docs/transformers/v5.23.0/ar/model_doc/clip#transformers.CLIPTokenizer) لمزيد من المعلومات.
#### __call__[[transformers.CLIPSegProcessor.__call__]]
```python
__call__(text = None, images = None, visual_prompt = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/processing_clipseg.py#L28)
**المعاملات:**
text (``) : The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, set `is_split_into_words=True` لتجنب الغموض مع المدخلات المُجمَّعة.
images (``) : Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, set `do_rescale=False`.
visual_prompt (`PIL.Image.Image`، `np.ndarray`، `torch.Tensor`، `list[PIL.Image.Image]`، `list[np.ndarray]`، `list[torch.Tensor]`) : صورة الإيحاء البصري أو دفعة من الصور التي يجب تجهيزها. يمكن أن تكون كل صورة إيحاء بصري صورة PIL أو مصفوفة NumPy أو متجه PyTorch. في حالة استخدام مصفوفة NumPy/متجه PyTorch، يجب أن تكون كل صورة من الشكل (C, H, W)، حيث C هو عدد القنوات، وH وW هما ارتفاع الصورة وعرضها.
return_tensors (`str` أو [TensorType](/docs/transformers/v5.23.0/ar/internal/file_utils#transformers.TensorType)، *اختياري*) : إذا تم تعيينه، فسيُرجع تينسورات من إطار عمل محدد. القيم المقبولة هي: - `'pt'`: يُرجع كائنات `torch.Tensor` من PyTorch. - `'np'`: يُرجع كائنات `np.ndarray` من NumPy.
**يعيد:** [BatchEncoding](/docs/transformers/v5.23.0/ar/main_classes/tokenizer#transformers.BatchEncoding)
[BatchEncoding](/docs/transformers/v5.23.0/ar/main_classes/tokenizer#transformers.BatchEncoding) يحتوي على الحقول التالية:
- **input_ids** -- قائمة معرّفات الرموز التي تُغذّى بها النموذج. تُعاد عندما لا تكون `text` قيمة `None`.
- **attention_mask** -- قائمة بالفهارس تحدد الرموز التي يجب أن يوليها النموذج انتباهه (عندما يكون `return_attention_mask=True` أو إذا كان *"attention_mask"* ضمن `self.model_input_names` وإذا لم يكن `text` مساوياً لـ `None`).
- **pixel_values** -- قيم البكسلات التي تُمرَّر إلى النموذج. تُعاد عندما لا تكون `images` قيمة `None`.
## CLIPSegModel[[transformers.CLIPSegModel]]
#### transformers.CLIPSegModel[[transformers.CLIPSegModel]]
```python
transformers.CLIPSegModel(config: CLIPSegConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L783)
**المعاملات:**
config ([CLIPSegConfig](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج Clipseg الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.CLIPSegModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L877)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام [ViTImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vit#transformers.ViTImageProcessor). راجع [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([CLIPSegProcessor](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegProcessor) يستخدم [ViTImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vit#transformers.ViTImageProcessor) لمعالجة الصور).
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
position_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
return_loss (`bool`، *اختياري*) : ما إذا كان يجب إرجاع خسارة التباينية أم لا.
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
**يعيد:** `CLIPSegOutput` أو `tuple(torch.Tensor)`
`CLIPSegOutput` أو مجموعة مرتبة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتمادًا على الإعداد ([CLIPSegConfig](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegConfig)) والمدخلات.
تتجاوز طريقة [CLIPSegModel](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegModel) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` of shape `(1,)`, *اختياري*, يُعاد عندما تكون `return_loss` هي `True`) -- خسارة تباينية (Contrastive loss) لتقدير التشابه بين الصورة والنص.
- **logits_per_image** (`torch.Tensor` من الشكل `(image_batch_size, text_batch_size)`) -- درجات ضرب النقطة المُقيَّسة بين `image_embeds` و`text_embeds`. وهذا يمثل درجات التشابه بين الصورة والنص.
- **logits_per_text** (`torch.Tensor` من الشكل `(text_batch_size, image_batch_size)`) -- درجات ضرب النقطة المُقيَّسة بين `text_embeds` و`image_embeds`. تمثل هذه الدرجات درجات التشابه بين النص والصورة.
- **text_embeds** (`torch.Tensor` من الشكل `(batch_size, output_dim`) -- تمثيلات النص (embeddings) التي تم الحصول عليها من خلال تطبيق طبقة الإسقاط (projection layer) على المخرجات المجمعة (pooled output) لـ [CLIPSegTextModel](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegTextModel).
- **image_embeds** (`torch.Tensor` من الشكل `(batch_size, output_dim`) -- تمثيلات الصور التي تم الحصول عليها من خلال تطبيق طبقة الإسقاط على المخرجات المجمعة لـ [CLIPSegVisionModel](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegVisionModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`، *اختياري*) -- مخرجات [CLIPSegTextModel](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`، *اختياري*) -- مخرجات [CLIPSegVisionModel](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegVisionModel).
أمثلة:
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(
... text=["a photo of a cat", "a photo of a dog"], images=image, return_tensors="pt", padding=True
... )
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> logits_per_image = outputs.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
```
#### get_text_features[[transformers.CLIPSegModel.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L804)
**المعاملات:**
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
position_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([CLIPSegConfig](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegConfig)) والمدخلات.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> import torch
>>> from transformers import AutoTokenizer, CLIPSegModel
>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.CLIPSegModel.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L839)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`) : المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام [ViTImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vit#transformers.ViTImageProcessor). راجع [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([CLIPSegProcessor](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegProcessor) يستخدم [ViTImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vit#transformers.ViTImageProcessor) لمعالجة الصور).
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([CLIPSegConfig](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegConfig)) والمدخلات.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_features = model.get_image_features(**inputs)
```
## CLIPSegTextModel[[transformers.CLIPSegTextModel]]
#### transformers.CLIPSegTextModel[[transformers.CLIPSegTextModel]]
```python
transformers.CLIPSegTextModel(config: CLIPSegTextConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L594)
**المعاملات:**
config ([CLIPSegTextConfig](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegTextConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج النص من CLIPSEG دون أي رأس أو إسقاط في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.CLIPSegTextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L610)
**المعاملات:**
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
position_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([CLIPSegConfig](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegConfig)) والمدخلات.
تتجاوز طريقة [CLIPSegTextModel](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegTextModel) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import AutoTokenizer, CLIPSegTextModel
>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegTextModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## CLIPSegVisionModel[[transformers.CLIPSegVisionModel]]
#### transformers.CLIPSegVisionModel[[transformers.CLIPSegVisionModel]]
```python
transformers.CLIPSegVisionModel(config: CLIPSegVisionConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L694)
**المعاملات:**
config ([CLIPSegVisionConfig](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegVisionConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج الرؤية من CLIPSEG دون أي رأس أو إسقاط في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.CLIPSegVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor], interpolate_pos_encoding: bool | None = True, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L710)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام [ViTImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vit#transformers.ViTImageProcessor). راجع [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([CLIPSegProcessor](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegProcessor) يستخدم [ViTImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vit#transformers.ViTImageProcessor) لمعالجة الصور).
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([CLIPSegConfig](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegConfig)) والمدخلات.
تتجاوز طريقة [CLIPSegVisionModel](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegVisionModel) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> from transformers import AutoProcessor, CLIPSegVisionModel
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegVisionModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled CLS states
```
## CLIPSegForImageSegmentation[[transformers.CLIPSegForImageSegmentation]]
#### transformers.CLIPSegForImageSegmentation[[transformers.CLIPSegForImageSegmentation]]
```python
transformers.CLIPSegForImageSegmentation(config: CLIPSegConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L961)
**المعاملات:**
config ([CLIPSegConfig](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج CLIPSeg مزوّد بمفكّك (decoder) مبني على تقنية Transformer في الأعلى، لأداء تقطيع الصور بدون تدريب مسبق (zero-shot) أو بتدريب على مثال واحد (one-shot).
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.CLIPSegForImageSegmentation.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, conditional_pixel_values: typing.Optional[torch.Tensor] = None, conditional_embeddings: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L1001)
**المعاملات:**
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام [ViTImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vit#transformers.ViTImageProcessor). راجع [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([CLIPSegProcessor](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegProcessor) يستخدم [ViTImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vit#transformers.ViTImageProcessor) لمعالجة الصور).
conditional_pixel_values (`torch.Tensor`، *اختياري*) : قيم البكسلات للصور الشرطية.
conditional_embeddings (`torch.Tensor` من الشكل `(batch_size, config.projection_dim)`، *اختياري*) : التضمينات الشرطية لصور الاستعلام. إذا تم توفيرها، سيقوم النموذج باستخدامها بدلاً من حساب التضمينات من conditional_pixel_values.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
position_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
labels (`torch.Tensor` من الشكل `(batch_size, height, width)`، *اختياري*) : أقنعة التقطيع الصحيحة (Ground truth segmentation masks)، بقيم ضمن `[0, 1]` وحجم مكاني مطابق لحجم `logits`. يتم حساب خسارة الانتروبيا المتقاطعة الثنائية (binary cross-entropy loss) بين القيم المتوقعة (logits) وأقنعة التقطيع هذه.
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
**يعيد:** `CLIPSegOutput` أو `tuple(torch.Tensor)`
`CLIPSegOutput` أو مجموعة مرتبة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتمادًا على الإعداد ([CLIPSegConfig](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegConfig)) والمدخلات.
تتجاوز طريقة [CLIPSegForImageSegmentation](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` of shape `(1,)`, *اختياري*, يُعاد عندما تكون `return_loss` هي `True`) -- خسارة تباينية (Contrastive loss) لتقدير التشابه بين الصورة والنص.
- **logits_per_image** (`torch.Tensor` من الشكل `(image_batch_size, text_batch_size)`) -- درجات ضرب النقطة المُقيَّسة بين `image_embeds` و`text_embeds`. وهذا يمثل درجات التشابه بين الصورة والنص.
- **logits_per_text** (`torch.Tensor` من الشكل `(text_batch_size, image_batch_size)`) -- درجات ضرب النقطة المُقيَّسة بين `text_embeds` و`image_embeds`. تمثل هذه الدرجات درجات التشابه بين النص والصورة.
- **text_embeds** (`torch.Tensor` من الشكل `(batch_size, output_dim`) -- تمثيلات النص (embeddings) التي تم الحصول عليها من خلال تطبيق طبقة الإسقاط (projection layer) على المخرجات المجمعة (pooled output) لـ [CLIPSegTextModel](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegTextModel).
- **image_embeds** (`torch.Tensor` من الشكل `(batch_size, output_dim`) -- تمثيلات الصور التي تم الحصول عليها من خلال تطبيق طبقة الإسقاط على المخرجات المجمعة لـ [CLIPSegVisionModel](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegVisionModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`، *اختياري*) -- مخرجات [CLIPSegTextModel](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`، *اختياري*) -- مخرجات [CLIPSegVisionModel](/docs/transformers/v5.23.0/ar/model_doc/clipseg#transformers.CLIPSegVisionModel).
أمثلة:
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegForImageSegmentation
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegForImageSegmentation.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> texts = ["a cat", "a remote", "a blanket"]
>>> inputs = processor(text=texts, images=[image] * len(texts), padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> logits = outputs.logits
>>> print(logits.shape)
torch.Size([3, 352, 352])
```