# CLIPSeg
## Resumen
El modelo CLIPSeg se propuso en [Image Segmentation Using Text and Image Prompts](https://huggingface.co/papers/2112.10003) de Timo Lüddecke y Alexander Ecker. CLIPSeg añade un decodificador mínimo sobre un modelo [CLIP](clip) congelado para la segmentación de imágenes en modo zero-shot y one-shot.
El resumen del artículo es el siguiente:
*La segmentación de imágenes suele abordarse entrenando un modelo para un conjunto fijo de clases de objetos. Incorporar clases adicionales o consultas más complejas más adelante resulta costoso, ya que requiere volver a entrenar el modelo con un conjunto de datos que abarque estas expresiones. Aquí proponemos un sistema que puede generar segmentaciones de imágenes basadas en prompts arbitrarios en el momento de la prueba. Un prompt puede ser un texto o una imagen. Este enfoque nos permite crear un modelo unificado (entrenado una sola vez) para tres tareas comunes de segmentación, que presentan desafíos distintos: segmentación de expresiones de referencia, segmentación zero-shot y segmentación one-shot. Nos basamos en el modelo CLIP como columna vertebral, que extendemos con un decodificador basado en transformers que permite la predicción densa. Después de entrenar en una versión extendida del conjunto de datos PhraseCut, nuestro sistema genera un mapa de segmentación binario para una imagen basándose en un prompt de texto libre o en una imagen adicional que expresa la consulta. Analizamos en detalle diferentes variantes de estos prompts basados en imágenes. Esta entrada híbrida novedosa permite una adaptación dinámica no solo a las tres tareas de segmentación mencionadas anteriormente, sino a cualquier tarea de segmentación binaria en la que se pueda formular una consulta de texto o imagen. Finalmente, encontramos que nuestro sistema se adapta bien a consultas generalizadas que implican affordances o propiedades*
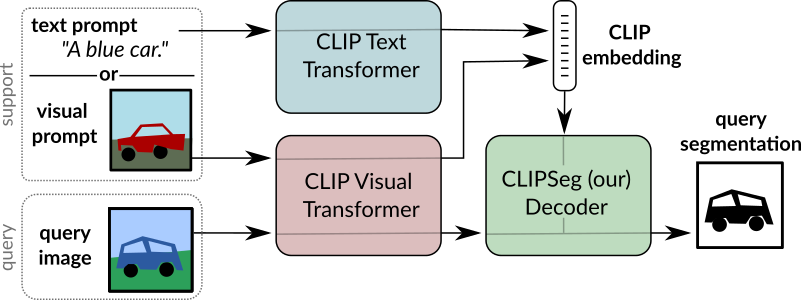 Resumen de CLIPSeg. Tomado del artículo original.
Este modelo fue aportado por [nielsr](https://huggingface.co/nielsr). El código original se puede encontrar [aquí](https://github.com/timojl/clipseg).
## Consejos de uso
- [CLIPSegForImageSegmentation](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) añade un decodificador sobre [CLIPSegModel](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegModel). Este último es idéntico a [CLIPModel](/docs/transformers/v5.23.0/es/model_doc/clip#transformers.CLIPModel).
- [CLIPSegForImageSegmentation](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) puede generar segmentaciones de imagen basadas en prompts arbitrarios en tiempo de prueba. Un prompt puede ser un texto
(proporcionado al modelo como `input_ids`) o una imagen (proporcionada al modelo como `conditional_pixel_values`). También se pueden proporcionar embeddings condicionales personalizados (proporcionados al modelo como `conditional_embeddings`).
## Recursos
Una lista de recursos oficiales de Hugging Face y de la comunidad (indicados con 🌎) para ayudarte a empezar con CLIPSeg. Si te interesa enviar un recurso para que se incluya aquí, no dudes en abrir una Pull Request y lo revisaremos. Lo ideal es que el recurso demuestre algo nuevo en lugar de duplicar un recurso existente.
- Un cuaderno que ilustra la [segmentación de imágenes sin ejemplos con CLIPSeg](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/CLIPSeg/Zero_shot_image_segmentation_with_CLIPSeg.ipynb).
## CLIPSegConfig[[transformers.CLIPSegConfig]]
#### transformers.CLIPSegConfig[[transformers.CLIPSegConfig]]
```python
transformers.CLIPSegConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, text_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegTextConfig | None = None, vision_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegVisionConfig | None = None, projection_dim: int | None = 512, logit_scale_init_value: float | int | None = 2.6592, initializer_factor: float | None = 1.0, extract_layers: list[int] | tuple[int, ...] = (3, 6, 9), reduce_dim: int = 64, decoder_num_attention_heads: int = 4, decoder_attention_dropout: float | int = 0.0, decoder_hidden_act: str = 'quick_gelu', decoder_intermediate_size: int = 2048, conditional_layer: int = 0, use_complex_transposed_convolution: bool = False)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/configuration_clipseg.py#L124)
**Parámetros:**
text_config (`Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegTextConfig]`, *opcional*) : El objeto de configuración o el diccionario del backbone de texto.
vision_config (`Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegVisionConfig]`, *opcional*) : El objeto de configuración o el diccionario del backbone de visión.
projection_dim (`int`, *opcional*, valor predeterminado `512`) : Dimensionalidad de las capas de proyección de texto y visión.
logit_scale_init_value (`Union[float, int]`, *opcional*, valor predeterminado `2.6592`) : El valor inicial del parámetro *logit_scale*.
initializer_factor (`float`, *opcional*, valor predeterminado `1.0`) : Un factor para inicializar todas las matrices de pesos (debe mantenerse en 1, se usa internamente para pruebas de inicialización).
extract_layers (`list[int]`, *opcional*, valor predeterminado `[3, 6, 9]`) : Capas que se extraen al hacer la propagación hacia adelante de la imagen de consulta a través del tronco visual congelado de CLIP.
reduce_dim (`int`, *opcional*, valor predeterminado 64) : Dimensionalidad a la que reducir la incrustación visual de CLIP.
decoder_num_attention_heads (`int`, *opcional*, valor predeterminado `4`) : Número de cabezas de atención para cada capa de atención en el decodificador del Transformer.
decoder_attention_dropout (`Union[float, int]`, *opcional*, valor predeterminado `0.0`) : La proporción de dropout para las probabilidades de atención.
decoder_hidden_act (`str`, *opcional*, valor predeterminado `quick_gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
decoder_intermediate_size (`int`, *opcional*, valor predeterminado `2048`) : Dimensión de las representaciones MLP.
conditional_layer (`int`, *opcional*, valor predeterminado 0) : La capa del codificador Transformer cuyas activaciones se combinarán con los embeddings de condición mediante FiLM (Feature-wise Linear Modulation). Si es 0, se utiliza la última capa.
use_complex_transposed_convolution (`bool`, *opcional*, valor predeterminado `False`) : Indica si se debe utilizar una convolución transpuesta más compleja en el decodificador, lo que permite una segmentación más detallada.
Esta es la clase de configuración para almacenar la configuración de un CLIPSegModel. Se utiliza para instanciar un modelo Clipseg según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import CLIPSegConfig, CLIPSegModel
>>> # Initializing a CLIPSegConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegConfig()
>>> # Initializing a CLIPSegModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a CLIPSegConfig from a CLIPSegTextConfig and a CLIPSegVisionConfig
>>> # Initializing a CLIPSegText and CLIPSegVision configuration
>>> config_text = CLIPSegTextConfig()
>>> config_vision = CLIPSegVisionConfig()
>>> config = CLIPSegConfig(text_config=config_text, vision_config=config_vision)
```
## CLIPSegTextConfig[[transformers.CLIPSegTextConfig]]
#### transformers.CLIPSegTextConfig[[transformers.CLIPSegTextConfig]]
```python
transformers.CLIPSegTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 77, hidden_act: str = 'quick_gelu', layer_norm_eps: float | None = 1e-05, attention_dropout: int | float | None = 0.0, initializer_range: float = 0.02, initializer_factor: float | None = 1.0, pad_token_id: int | None = 1, bos_token_id: int | None = 49406, eos_token_id: int | list[int] | None = 49407)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/configuration_clipseg.py#L31)
**Parámetros:**
vocab_size (`int`, *opcional*, valor predeterminado `49408`) : Tamaño del vocabulario del modelo. Define el número de tokens diferentes que pueden representarse mediante `input_ids`.
hidden_size (`int`, *opcional*, valor predeterminado `512`) : Dimensión de las representaciones ocultas.
intermediate_size (`int`, *opcional*, valor predeterminado `2048`) : Dimensión de las representaciones MLP.
num_hidden_layers (`int`, *opcional*, valor predeterminado `12`) : Número de capas ocultas en el decodificador del Transformer.
num_attention_heads (`int`, *opcional*, valor predeterminado `8`) : Número de cabezas de atención para cada capa de atención en el decodificador del Transformer.
max_position_embeddings (`int`, *opcional*, valor predeterminado `77`) : La longitud máxima de secuencia con la que se podría utilizar este modelo.
hidden_act (`str`, *opcional*, valor predeterminado `quick_gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-05`) : El epsilon utilizado por las capas de normalización de capas.
attention_dropout (`Union[int, float]`, *opcional*, valor predeterminado `0.0`) : La proporción de dropout para las probabilidades de atención.
initializer_range (`float`, *opcional*, valor predeterminado `0.02`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
initializer_factor (`float`, *opcional*, valor predeterminado `1.0`) : Un factor para inicializar todas las matrices de pesos (debe mantenerse en 1, se usa internamente para pruebas de inicialización).
pad_token_id (`int`, *opcional*, valor predeterminado `1`) : Id de token utilizado para el relleno en el vocabulario.
bos_token_id (`int`, *opcional*, valor predeterminado `49406`) : Id del token utilizado para el inicio de la secuencia en el vocabulario.
eos_token_id (`Union[int, list[int]]`, *opcional*, valor predeterminado `49407`) : Id. de token utilizado para el fin de secuencia en el vocabulario.
Esta es la clase de configuración para almacenar la configuración de un CLIPSegModel. Se utiliza para instanciar un modelo Clipseg según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import CLIPSegTextConfig, CLIPSegTextModel
>>> # Initializing a CLIPSegTextConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegTextConfig()
>>> # Initializing a CLIPSegTextModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegTextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## CLIPSegVisionConfig[[transformers.CLIPSegVisionConfig]]
#### transformers.CLIPSegVisionConfig[[transformers.CLIPSegVisionConfig]]
```python
transformers.CLIPSegVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] | None = 224, patch_size: int | list[int] | tuple[int, int] | None = 32, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: int | float | None = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/configuration_clipseg.py#L80)
**Parámetros:**
hidden_size (`int`, *opcional*, valor predeterminado `768`) : Dimensión de las representaciones ocultas.
intermediate_size (`int`, *opcional*, valor predeterminado `3072`) : Dimensión de las representaciones MLP.
num_hidden_layers (`int`, *opcional*, valor predeterminado `12`) : Número de capas ocultas en el decodificador del Transformer.
num_attention_heads (`int`, *opcional*, valor predeterminado `12`) : Número de cabezas de atención para cada capa de atención en el decodificador Transformer.
num_channels (`int`, *opcional*, valor predeterminado `3`) : El número de canales de entrada.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `224`) : El tamaño (resolución) de cada imagen.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `32`) : El tamaño (resolución) de cada parche.
hidden_act (`str`, *opcional*, valor predeterminado `quick_gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-05`) : El epsilon utilizado por las capas de normalización de capas.
attention_dropout (`Union[int, float]`, *opcional*, valor predeterminado `0.0`) : La proporción de dropout para las probabilidades de atención.
initializer_range (`float`, *opcional*, valor predeterminado `0.02`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
initializer_factor (`float`, *opcional*, valor predeterminado `1.0`) : Un factor para inicializar todas las matrices de pesos (debe mantenerse en 1, se usa internamente para pruebas de inicialización).
Esta es la clase de configuración para almacenar la configuración de un CLIPSegModel. Se utiliza para instanciar un modelo Clipseg según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import CLIPSegVisionConfig, CLIPSegVisionModel
>>> # Initializing a CLIPSegVisionConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegVisionConfig()
>>> # Initializing a CLIPSegVisionModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## CLIPSegProcessor[[transformers.CLIPSegProcessor]]
#### transformers.CLIPSegProcessor[[transformers.CLIPSegProcessor]]
```python
transformers.CLIPSegProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/processing_clipseg.py#L24)
**Parámetros:**
image_processor (`ViTImageProcessor`) : El procesador de imágenes es un parámetro de entrada obligatorio.
tokenizer (`CLIPTokenizer`) : El tokenizador es una entrada obligatoria.
Construye un CLIPSegProcessor que envuelve un procesador de imágenes y un tokenizador en un único procesador.
[CLIPSegProcessor](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegProcessor) ofrece todas las funcionalidades de [ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor) y [CLIPTokenizer](/docs/transformers/v5.23.0/es/model_doc/clip#transformers.CLIPTokenizer). Consulte [~ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor) y [~CLIPTokenizer](/docs/transformers/v5.23.0/es/model_doc/clip#transformers.CLIPTokenizer) para obtener más información.
#### __llamada__[[transformers.CLIPSegProcessor.__call__]]
```python
__call__(text = None, images = None, visual_prompt = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/processing_clipseg.py#L28)
**Parámetros:**
text (``) : The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, set `is_split_into_words=True` to avoid ambiguity with batched inputs.
images (``) : Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, set `do_rescale=False`.
visual_prompt (`PIL.Image.Image`, `np.ndarray`, `torch.Tensor`, `list[PIL.Image.Image]`, `list[np.ndarray]`, `list[torch.Tensor]`) : La imagen de la indicación visual o el lote de imágenes que se deben preparar. Cada imagen de la indicación visual puede ser una imagen PIL, un array de NumPy o un tensor de PyTorch. En el caso de un array de NumPy/tensor de PyTorch, cada imagen debe tener la forma (C, H, W), donde C es el número de canales, y H y W son la altura y el ancho de la imagen, respectivamente.
return_tensors (`str` o [TensorType](/docs/transformers/v5.23.0/es/internal/file_utils#transformers.TensorType), *opcional*) : Si se establece, devolverá tensores de un marco de trabajo específico. Los valores aceptables son: - `'pt'`: Devuelve objetos `torch.Tensor` de PyTorch. - `'np'`: Devuelve objetos `np.ndarray` de NumPy.
**Devuelve:** [BatchEncoding](/docs/transformers/v5.23.0/es/main_classes/tokenizer#transformers.BatchEncoding)
Un [BatchEncoding](/docs/transformers/v5.23.0/es/main_classes/tokenizer#transformers.BatchEncoding) con los siguientes campos:
- **input_ids** -- Lista de ids de tokens que se enviarán a un modelo. Se devuelve cuando `text` no es `None`.
- **attention_mask** -- Lista de índices que especifica qué tokens deben ser atendidos por el modelo (cuando `return_attention_mask=True` o si *"attention_mask"* está en `self.model_input_names` y si `text` no es `None`).
- **pixel_values** -- Valores de píxeles que se enviarán a un modelo. Se devuelve cuando `images` no es `None`.
## CLIPSegModel[[transformers.CLIPSegModel]]
#### transformers.CLIPSegModel[[transformers.CLIPSegModel]]
```python
transformers.CLIPSegModel(config: CLIPSegConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L783)
**Parámetros:**
config ([CLIPSegConfig](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo Clipseg básico que emite estados ocultos sin ningún cabezal específico en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.CLIPSegModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L877)
**Parámetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor). Consulte [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles ([CLIPSegProcessor](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegProcessor) utiliza [ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor) para procesar las imágenes).
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
position_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
return_loss (`bool`, *opcional*) : Indica si se debe devolver la pérdida contrastiva.
interpolate_pos_encoding (`bool`, *opcional*, valor predeterminado `True`) : Si se debe interpolar las codificaciones de posición preentrenadas.
**Devuelve:** `CLIPSegOutput` o `tuple(torch.Tensor)`
Un `CLIPSegOutput` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([CLIPSegConfig](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegConfig)) y las entradas.
El método forward de [CLIPSegModel](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegModel) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, devuelta cuando `return_loss` es `True`) -- Pérdida contrastiva para la similitud imagen-texto.
- **logits_per_image** (`torch.Tensor` de forma `(image_batch_size, text_batch_size)`) -- Las puntuaciones de producto punto escalado entre `image_embeds` y `text_embeds`. Esto representa las puntuaciones de similitud entre imagen y texto.
- **logits_per_text** (`torch.Tensor` de forma `(text_batch_size, image_batch_size)`) -- Las puntuaciones de producto punto escalado entre `text_embeds` y `image_embeds`. Esto representa las puntuaciones de similitud texto-imagen.
- **text_embeds** (`torch.Tensor` de forma `(batch_size, output_dim`) -- Las incrustaciones de texto obtenidas al aplicar la capa de proyección a la salida agrupada de [CLIPSegTextModel](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegTextModel).
- **image_embeds** (`torch.Tensor` de forma `(batch_size, output_dim`) -- Los embeddings de imagen obtenidos al aplicar la capa de proyección a la salida agrupada de [CLIPSegVisionModel](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegVisionModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- La salida del [CLIPSegTextModel](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- La salida del [CLIPSegVisionModel](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegVisionModel).
Ejemplos:
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(
... text=["a photo of a cat", "a photo of a dog"], images=image, return_tensors="pt", padding=True
... )
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> logits_per_image = outputs.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
```
#### get_text_features[[transformers.CLIPSegModel.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L804)
**Parámetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
**Devuelve:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([CLIPSegConfig](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegConfig)) y las entradas.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto de la última capa del primer token de la secuencia (token de clasificación) después de un procesamiento adicional a través de las capas utilizadas para la tarea de preentrenamiento auxiliar. Por ejemplo, para la familia de modelos BERT, esto devuelve el token de clasificación después de procesarlo a través de una capa lineal y una función de activación tanh. Los pesos de la capa lineal se entrenan a partir del objetivo de predicción de la siguiente oración (clasificación) durante el preentrenamiento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> import torch
>>> from transformers import AutoTokenizer, CLIPSegModel
>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.CLIPSegModel.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L839)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor). Consulte [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles ([CLIPSegProcessor](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegProcessor) utiliza [ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor) para procesar las imágenes).
interpolate_pos_encoding (`bool`, *opcional*, valor predeterminado `True`) : Si se debe interpolar las codificaciones de posición preentrenadas.
**Devuelve:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([CLIPSegConfig](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegConfig)) y las entradas.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto de la última capa del primer token de la secuencia (token de clasificación) después de un procesamiento adicional a través de las capas utilizadas para la tarea de preentrenamiento auxiliar. Por ejemplo, para la familia de modelos BERT, esto devuelve el token de clasificación después de procesarlo a través de una capa lineal y una función de activación tanh. Los pesos de la capa lineal se entrenan a partir del objetivo de predicción de la siguiente oración (clasificación) durante el preentrenamiento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_features = model.get_image_features(**inputs)
```
## CLIPSegTextModel[[transformers.CLIPSegTextModel]]
#### transformers.CLIPSegTextModel[[transformers.CLIPSegTextModel]]
```python
transformers.CLIPSegTextModel(config: CLIPSegTextConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L594)
**Parámetros:**
config ([CLIPSegTextConfig](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegTextConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo de texto de CLIPSEG sin ninguna cabeza ni proyección en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.CLIPSegTextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L610)
**Parámetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
**Devuelve:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([CLIPSegConfig](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegConfig)) y las entradas.
El método forward de [CLIPSegTextModel](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegTextModel) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto de la última capa del primer token de la secuencia (token de clasificación) después de un procesamiento adicional a través de las capas utilizadas para la tarea de preentrenamiento auxiliar. Por ejemplo, para la familia de modelos BERT, esto devuelve el token de clasificación después de procesarlo a través de una capa lineal y una función de activación tanh. Los pesos de la capa lineal se entrenan a partir del objetivo de predicción de la siguiente oración (clasificación) durante el preentrenamiento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> from transformers import AutoTokenizer, CLIPSegTextModel
>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegTextModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## CLIPSegVisionModel[[transformers.CLIPSegVisionModel]]
#### transformers.CLIPSegVisionModel[[transformers.CLIPSegVisionModel]]
```python
transformers.CLIPSegVisionModel(config: CLIPSegVisionConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L694)
**Parámetros:**
config ([CLIPSegVisionConfig](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegVisionConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo de visión de CLIPSEG sin ninguna cabeza ni proyección en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.CLIPSegVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor], interpolate_pos_encoding: bool | None = True, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L710)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor). Consulte [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles ([CLIPSegProcessor](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegProcessor) utiliza [ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor) para procesar las imágenes).
interpolate_pos_encoding (`bool`, *opcional*, valor predeterminado `True`) : Si se debe interpolar las codificaciones de posición preentrenadas.
**Devuelve:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([CLIPSegConfig](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegConfig)) y las entradas.
El método forward de [CLIPSegVisionModel](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegVisionModel) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto de la última capa del primer token de la secuencia (token de clasificación) después de un procesamiento adicional a través de las capas utilizadas para la tarea de preentrenamiento auxiliar. Por ejemplo, para la familia de modelos BERT, esto devuelve el token de clasificación después de procesarlo a través de una capa lineal y una función de activación tanh. Los pesos de la capa lineal se entrenan a partir del objetivo de predicción de la siguiente oración (clasificación) durante el preentrenamiento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> from transformers import AutoProcessor, CLIPSegVisionModel
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegVisionModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled CLS states
```
## CLIPSegForImageSegmentation[[transformers.CLIPSegForImageSegmentation]]
#### transformers.CLIPSegForImageSegmentation[[transformers.CLIPSegForImageSegmentation]]
```python
transformers.CLIPSegForImageSegmentation(config: CLIPSegConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L961)
**Parámetros:**
config ([CLIPSegConfig](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
Modelo CLIPSeg con un decodificador basado en Transformer en la parte superior para segmentación de imágenes en modo zero-shot y one-shot.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.CLIPSegForImageSegmentation.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, conditional_pixel_values: typing.Optional[torch.Tensor] = None, conditional_embeddings: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L1001)
**Parámetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor). Consulte [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles ([CLIPSegProcessor](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegProcessor) utiliza [ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor) para procesar las imágenes).
conditional_pixel_values (`torch.Tensor`, *opcional*) : Los valores de píxel de las imágenes condicionales.
conditional_embeddings (`torch.Tensor` de forma `(batch_size, config.projection_dim)`, *opcional*) : Los embeddings condicionales para las imágenes de consulta. Si se proporciona, el modelo utilizará este en lugar de calcular los embeddings desde conditional_pixel_values.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
position_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
labels (`torch.Tensor` de forma `(batch_size, height, width)`, *opcional*) : Máscaras de segmentación de verdad, con valores en `[0, 1]` y el mismo tamaño espacial que `logits`. Se calcula una pérdida de entropía cruzada binaria entre los logits predichos y estas máscaras.
interpolate_pos_encoding (`bool`, *opcional*, valor predeterminado `True`) : Si se debe interpolar las codificaciones de posición preentrenadas.
**Devuelve:** `CLIPSegOutput` o `tuple(torch.Tensor)`
Un `CLIPSegOutput` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([CLIPSegConfig](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegConfig)) y las entradas.
El método forward de [CLIPSegForImageSegmentation](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, devuelta cuando `return_loss` es `True`) -- Pérdida contrastiva para la similitud imagen-texto.
- **logits_per_image** (`torch.Tensor` de forma `(image_batch_size, text_batch_size)`) -- Las puntuaciones de producto punto escalado entre `image_embeds` y `text_embeds`. Esto representa las puntuaciones de similitud entre imagen y texto.
- **logits_per_text** (`torch.Tensor` de forma `(text_batch_size, image_batch_size)`) -- Las puntuaciones de producto punto escalado entre `text_embeds` y `image_embeds`. Esto representa las puntuaciones de similitud texto-imagen.
- **text_embeds** (`torch.Tensor` de forma `(batch_size, output_dim`) -- Las incrustaciones de texto obtenidas al aplicar la capa de proyección a la salida agrupada de [CLIPSegTextModel](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegTextModel).
- **image_embeds** (`torch.Tensor` de forma `(batch_size, output_dim`) -- Los embeddings de imagen obtenidos al aplicar la capa de proyección a la salida agrupada de [CLIPSegVisionModel](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegVisionModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- La salida del [CLIPSegTextModel](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- La salida del [CLIPSegVisionModel](/docs/transformers/v5.23.0/es/model_doc/clipseg#transformers.CLIPSegVisionModel).
Ejemplos:
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegForImageSegmentation
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegForImageSegmentation.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> texts = ["a cat", "a remote", "a blanket"]
>>> inputs = processor(text=texts, images=[image] * len(texts), padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> logits = outputs.logits
>>> print(logits.shape)
torch.Size([3, 352, 352])
```